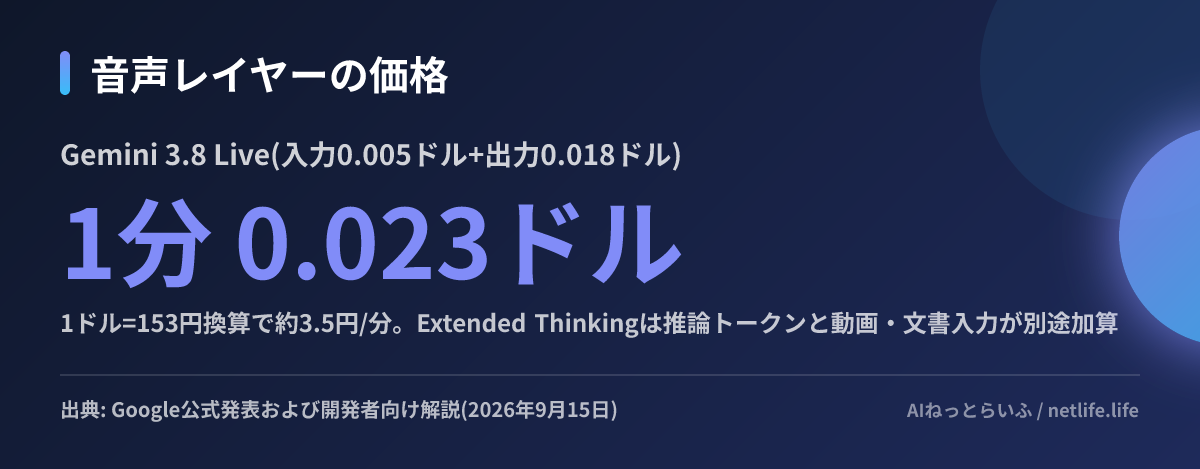
Googleが2026年9月15日、音声対話向けの Gemini 3.8 Live と Gemini 3.8 Live Extended Thinking を公開しました。音声を直接受け取って音声で返す構成で、Extended Thinkingのほうは「考えている間も黙らない」ことを狙った変わり種です。価格は音声入力が1分0.005ドル、出力が1分0.018ドル。5日前に出たOpenAIのGPT-Live-1と比べると、単純な合算でおよそ半分です。音声エージェントを検討しているチームにとっては、性能の話より先に見積もりが動く発表です。
「話しながら考える」とは何をしているのか
音声エージェントで一番気まずいのは、複雑な依頼をしたあとの沈黙です。裏でツールを呼んだり検索したりしている間、モデルは黙るしかなく、利用者は切れたのかと思って話しかけてしまいます。
Extended Thinkingはここを分けました。推論と発話を同時に走らせ、裏で処理をしている間は「確認しますね」といった相づちを返し続けます。Googleはこれを、会話の流れを止めずに複数ステップの作業をこなすための仕組みだと説明しています。ツール呼び出しやAPI呼び出しも、対話を中断せずにバックグラウンドで実行されます。
実装としては珍しくありませんが、モデル側の標準機能として出てきた点が効きます。これまでは「考えている風の相づちを別途TTS(音声合成)で挟む」といった作り込みをアプリ側でやる必要がありました。その部分をモデルが持つなら、自前のパイプラインから消せるコードがあります。
数字はどこまで出ているか
Googleが挙げているのは次の値です。Extended ThinkingがArtificial AnalysisのSpeech to Speech Quality Indexで82.6を記録して首位、無印の3.8 LiveはSpeech Agent Arenaで2位。エージェント的な完了率を測るτ-Voiceで68.6%、音声での推論を測るBig Bench Audioで97.7%。SiliconANGLEの 報道 によれば、82.6はGPT-Live-1-Astraを上回る値です。
いずれもベンチマークなので、自社の用途がそのまま乗るとは限りません。とくにτ-Voiceの68.6%は「3回に1回は完了しない」という読み方もできる水準で、人間へのエスカレーション設計を省ける数字ではないと考えられます。
対応言語は97。会話の途中で言語が変わっても自動で追随するとされています。出力音声にはSynthIDの電子透かしが入ります。
同時に出た音声モデル群
今回は1モデルの発表ではなく、音声まわりのラインアップがまとめて更新されています。
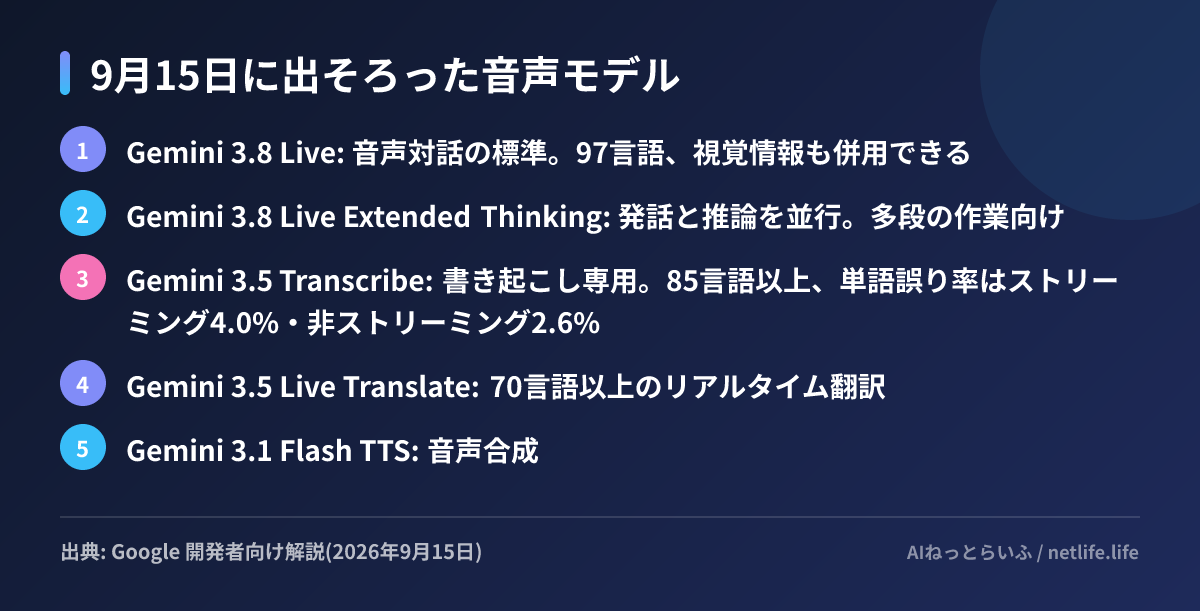
3.5 Transcribeには、専門用語を最大1,000語まで登録して認識を寄せるカスタム語彙の機能と、会話中に言語が混ざった場合の自動切り替えが入っています。社内用語や商品名が多い議事録では、ここが精度を左右します。書き起こしだけが目的なら、 1時間0.10ドルのMAI-Transcribe-2 のような専用モデルと並べて比較する対象になります。
提供はGemini APIとGoogle AI Studioで即日開始。Gemini Enterpriseはプライベートプレビューです。Pipecat、LiveKit、LangChain、Agora、Vercelといった音声アプリ向けの基盤側も対応を表明しています。
日本の読者にとって
まず価格です。1ドル153円で換算すると、入出力あわせて1分およそ3.5円、1時間で約210円になります。 GPT-Live-1は音声レイヤーが1分0.05ドル なので、同じ1時間で約460円。ただしOpenAI側は入出力を分けていない表記で、Googleは入力と出力で単価が違い、Extended Thinkingでは推論トークンが別途かかります。実際の会話は話す時間と聞く時間が同じではないので、この比較はあくまで桁の目安です。自社の通話ログから「1件あたり何分、うち何割がモデルの発話か」を出さないと、どちらが安いかは決まりません。
日本語については、97言語に対応するという記述はあるものの、公式発表で日本語を名指しした説明はありません。音声モデルは言語ごとに品質差が出やすい領域なので、導入前に自社の想定シナリオで試す必要があります。とくに数字や英数字混じりの型番を読み上げる場面は、日本語の音声認識が崩れやすいところです。Googleは英数字の正確さを改善点として挙げていますが、日本語での検証結果は公開されていません。
次にやること
- 手元の音声エージェントで「沈黙が発生している箇所」を洗い出す。Extended Thinkingが効くのはそこだけで、単純な一問一答なら無印の3.8 Liveで足ります
- 通話1件あたりの分数と、モデル発話が占める割合を実データから出す。入力と出力で単価が3.6倍違うため、この比率で見積もりが変わります
- 書き起こし用途と対話用途を分けて考える。同じ「音声AI」でも価格の桁が違います