Microsoft AIは2026年9月3日、自社開発の音声認識(文字起こし)モデル「MAI-Transcribe-2」を公開しました。価格は音声1時間あたり0.10ドルで、これは2026年12月31日までの期間限定です。対応言語は60で、Microsoftの公式ドキュメントの対応表には日本語(ja)が含まれています。会議の議事録、コールセンターの通話記録、動画の字幕など、大量の音声を文字にしている日本の企業にとって、単価と精度の両面で選択肢が1つ増えたことになります。
「速くて安い」の中身
Microsoft AIの発表文は、多言語音声認識のベンチマークFLEURSで60言語の平均WER(Word Error Rate。単語誤り率で、低いほど良い)が5.2%となり首位だとしています。第三者の評価サイトArtificial AnalysisのWERリーダーボードでは2位ですが、精度と応答時間の両立を示すパレートフロンティア(どちらかを犠牲にせず両方で優れた点の集まり)では先頭にあると述べています。速度については「OpenAIのGPT-Transcribeの10倍、ElevenLabsのScribe v2の7倍、Gemini 3.5 Transcribeの5倍速い」と、競合の名前を挙げて比較しているのが特徴です。
ただし、この数字はすべてMicrosoft側の発表です。FLEURSは読み上げ音声のデータセットなので、雑音のある会議室や電話回線の音声で同じ差が出るとは限りません。また、5.2%は60言語の平均であり、日本語単体のWER(日本語では文字単位のCERで測ることが多い)は公表されていません。Artificial Analysisで2位というのは、精度だけなら上がいるということでもあります。
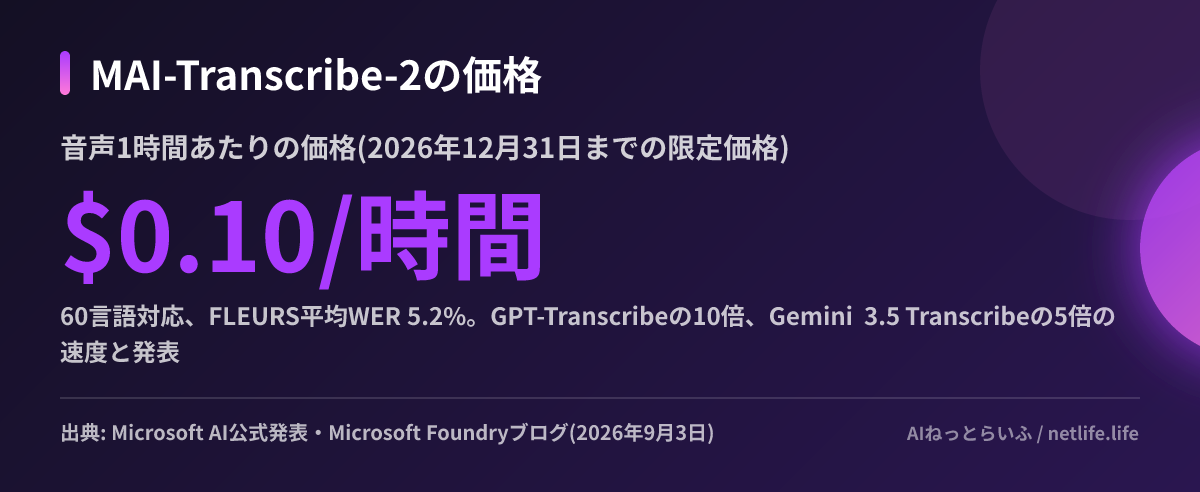
背景には、音声認識が「モデルの性能勝負」から「単価と周辺機能の勝負」に移っていることがあります。OpenAIのGPT-Transcribe、GoogleのGemini 3.5 Transcribe(8月公開)、ElevenLabsのScribe v2と、この数か月で各社が文字起こし専用モデルを出し揃えており、精度は上位で拮抗しています。VentureBeatによれば、Microsoftは4月に初代MAI-Transcribe-1を25言語で出し、1.5で43言語に広げ、今回60言語にした流れで、初代の価格は1時間0.36ドルでした。今回の0.10ドルは初代比で約72%の値下げに相当しますが、あくまで年内の限定価格で、2027年以降の通常価格は発表されていません。
1.5から何が変わったか
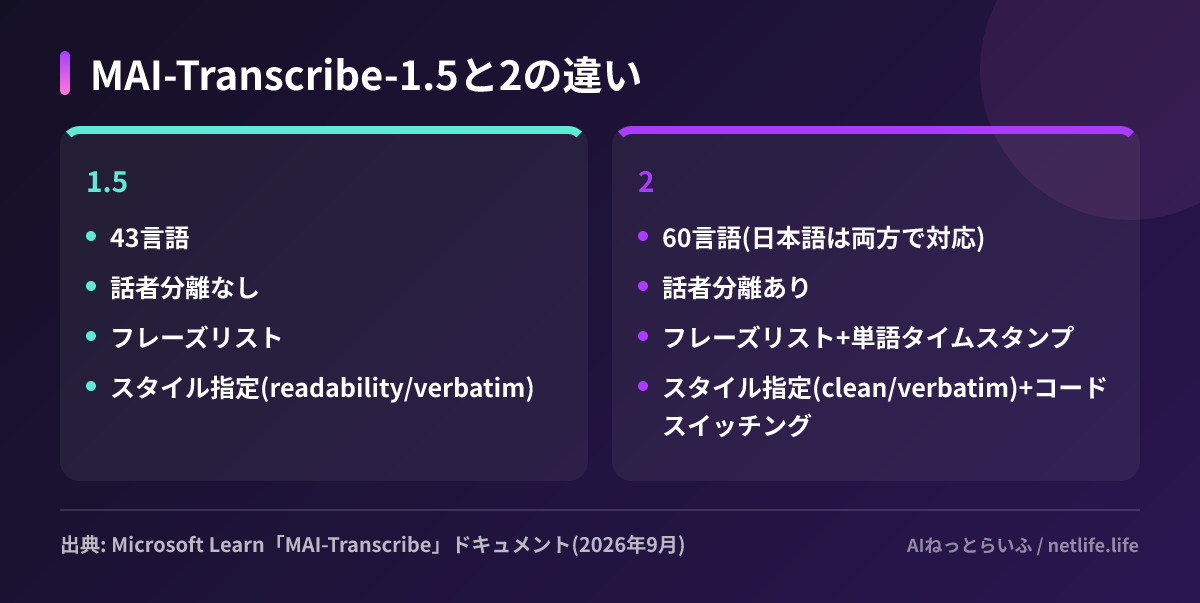
Microsoft Learnのドキュメントを見ると、機能面の差がはっきりします。前版のMAI-Transcribe-1.5では話者分離(ダイアライゼーション。誰が話したかを区別する機能)が非対応でしたが、2ではdiarization.enabledを有効にすると話者ラベル付きのセグメントが返ります。単語ごとのタイムスタンプ、専門用語や製品名を優先させるキーワードバイアス(phraseList.phrases)、フィラーを除いた読みやすい書き起こしか一字一句そのままかを選ぶスタイル指定(transcribeStyle)、言語の自動判定、ヒングリッシュ(ヒンディー語と英語の混在)のように会話の途中で言語が切り替わるコードスイッチングにも対応します。なお、初代のMAI-Transcribe-1は2026年8月20日付で非推奨になっています。
使い方は、Azure Speechの「Fast Transcription」API(speechtotext/transcriptions:transcribe、api-version 2025-10-15)でenhancedMode.enabledをtrueにし、enhancedMode.modelにMAI-Transcribe-2を指定する形です。入力は300MB未満の音声ファイルで、対応形式はWAV、MP3、FLACです。つまり現時点では録音済みファイルを渡すバッチ処理が前提で、マイク入力をリアルタイムに文字にするストリーミング用途については発表文にもドキュメントにも記載がありません。会議中の同時字幕のような用途を考えている場合は、この点を確認してからにしたほうがよいでしょう。提供形態は公開プレビューで、Microsoft Foundry、MAI Playground、OpenRouterから試せます。
日本の読者にとって
日本語が60言語に含まれているため、日本語の音声をそのまま投げられます。一方で、ドキュメントのリージョン表でMAI-Transcribeモデルが使えるのはcentralindia、eastus、northeurope、southeastasia、westus、westus2の6リージョンで、東日本・西日本リージョンは含まれていません(9月4日時点)。音声データを国内に置く必要がある業種では、この時点では採用が難しいと考えられます。最も近いのはシンガポールのsoutheastasiaです。
コストの目安を出しておきます。為替を1ドル150円と仮定すると、1時間の音声が約15円、月に1,000時間の通話を処理するコールセンターで月約1万5,000円です。人手の文字起こしと比べれば桁が違う水準なので、「精度が実用に達しているなら乗り換える価値がある」という判断になりやすい価格設定です。ただし限定価格である点と、公開プレビュー段階でSLA(サービス品質保証)が確認できない点は、稟議に書いておく必要があります。
次にやることは3つです。第一に、自社の実データ(会議録音や通話録音を数本)をtranscribeStyle: "clean"と"verbatim"の両方で通し、固有名詞の誤りをphraseListでどこまで減らせるかを見ること。第二に、リアルタイム字幕が要件なら、現状のバッチAPIで足りるのか、別のストリーミングAPIと組み合わせるのかを整理すること。第三に、年内の限定価格と2027年以降の価格が変わる前提で、他社APIに切り替えられるよう出力形式(タイムスタンプや話者ラベル)を自社側で正規化しておくことです。