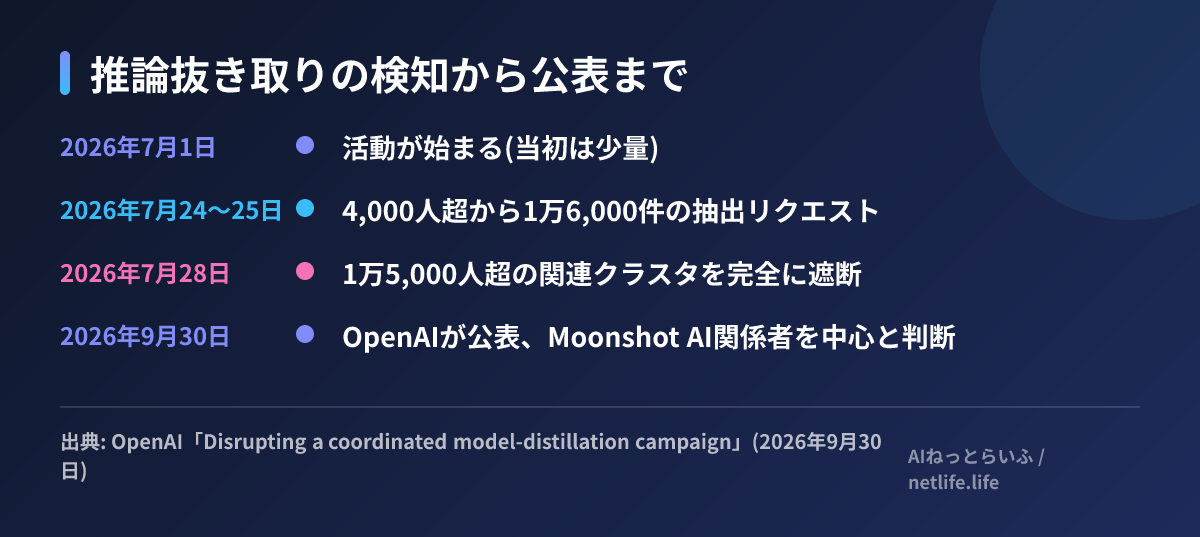
OpenAIは2026年9月30日(米国時間)、自社モデルの「隠れた推論」を組織的に抜き取ろうとする活動を7月に検知し、止めたと 公表しました 。7月24〜25日には4,000人以上の利用者から1万6,000件の抽出リクエストが集中しました。OpenAIは、その中心を中国のAIチャット「Kimi」を開発するMoonshot AIの関係者と判断しています。暗号を破ったわけではなく、暗号化された推論を別の会話に持ち込んで「解読させる」という手口でした。APIで推論モデルを使う開発者や、自社でモデルを提供する事業者にとっては、防御の考え方が変わる事例です。
何が起きたのか
蒸留(distillation)とは、高性能なモデルの出力を教材にして別のモデルを学習させる手法です。手法そのものはAI開発で一般的ですが、他社の利用規約に反して大量に出力を集める「敵対的蒸留」は、各社が警戒を強めています。
今回狙われたのは、回答そのものではなく、その手前でモデルが考えた過程(推論)でした。OpenAIの推論モデルは、この過程を利用者にそのまま見せず、暗号化した形で扱います。攻撃者はこの暗号化された推論を、ある会話からコピーし、別の会話でモデルに「解読して書き起こして」と頼んでいました。OpenAIは「暗号を破ったり、データベースを侵害したり、保存された会話に直接アクセスしたりはしていない」と説明しています。つまり、正規の使い方の組み合わせで守られているはずの中身を取り出した、ということです。
経緯は次のとおりです。
独立したセキュリティ研究者からも、別のモデルをまたぐ攻撃や、会話の圧縮(長い会話を要約して文脈を詰める処理、コンパクション)を突く関連の脆弱性が、責任ある開示の手続きで報告されていたとしています。技術的な詳細は公表されていません。
帰属の書き方と、これまでの流れ
OpenAIは帰属について慎重な書き方をしています。「観測したすべての実行者が単一の主体から来たのかは不明」としたうえで、「中核のクラスタはMoonshot AIに関係する個人によるもの」と判断しました。会社として組織的に指示したとまでは書いていない点は、読み分けが必要です。
背景には、蒸留をめぐる米国の動きがあります。9月8日には米NSA・FBI・CISAが、中国のAI企業6社が米国のモデルから能力を抜き出していると警告する共同助言を出し、Moonshot AIもその中で名指しされていました( 当サイトの記事 )。Anthropicも、Claude APIで推論の抜き出しを狙う要求をreasoning_extractionという拒否分類で扱っています( 出力前の拒否への課金再開の記事 )。今回は、提供側の企業が具体的な件数と手口を添えて公表した事例です。
OpenAIが問題視する理由は2つあります。1つは、抜き出した推論で別のモデルを学習させると、元のモデルの出力にかけていた安全対策が引き継がれないこと。もう1つは、安全への投資を省いたまま高度な能力が移ってしまうことです。
OpenAIが取った対策
対策は、アカウントの取り締まりと、技術的な穴ふさぎの両面です。
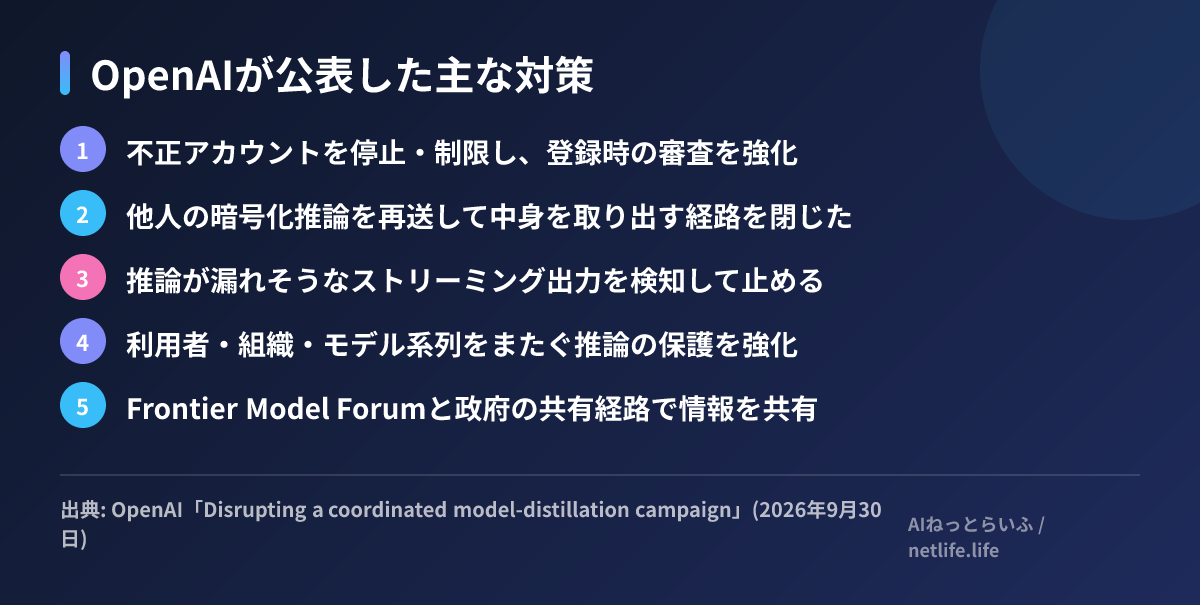
技術面で重要なのは、「他人の暗号化された推論を持っている者が、それを再送して中身を取り出せる経路を閉じた」という点です。あわせて、推論の保護を「利用者、ワークスペース、組織、モデル系列をまたいで」強化したとしています。業界団体のFrontier Model Forum(大手AI企業が安全対策を共有する枠組み)を通じて他社とも情報を共有しました。
OpenAIは、パートナー企業がホストする提供形態も自社サービスと同じ保護が必要だと書いています。クラウド経由でOpenAIのモデルを使う場合も、今後同じ種類の対策が入っていくと考えられます。
日本の読者にとって
影響は立場によって分かれます。
APIで推論モデルを使っている開発者は、暗号化された推論の扱いに注意が必要です。OpenAIのAPIでは、データを保持しない設定などで、暗号化された推論を次のリクエストに渡し直して文脈を引き継ぐ使い方があります。今回「利用者や組織、モデル系列をまたぐ」保護を強めたとしているので、別のモデルや別のプロジェクトに推論をそのまま持ち回すような実装は、今後通らなくなる可能性があります。公式の仕様変更は現時点で示されていませんが、エラーが出たときに疑う箇所として覚えておく価値はあります。
自社でLLMのAPIやチャットを提供している事業者にとっては、「暗号化しているから安全」とは言えない事例です。モデル自身に解読させるという抜け道は、暗号の強さとは別の問題です。OpenAIは、ツールの出力を使った攻撃には「目に見える普通のテキスト以上を調べる」保護が要ると書いています。
中国製モデルを業務で使っている企業は、今回の件だけで利用を止める理由にはなりません。ただ、米国側の規制や調達方針が今後厳しくなる可能性があり、取引先に米国企業や官公庁がある場合は、採用しているモデルの出どころを説明できるようにしておくと安心です。
次にやることを3つ挙げます。1つ目、OpenAIのAPIで暗号化された推論(encrypted_content)を再利用している箇所を洗い出し、別モデルや別組織に渡していないか確認する。2つ目、自社サービスを提供しているなら、モデルに「隠れた情報を書き起こさせる」依頼をログから検索できるようにしておく。3つ目、業務で使っているモデルの一覧に、開発元と提供経路を書き足しておく。