OpenAIが2026年9月10日、音声モデルGPT-Live-1をAPIで提供開始しました。聞くことと話すことを同時に行う「全二重(full-duplex)」の構成で、これまで音声認識(ASR)→言語モデル→音声合成(TTS)と三段に繋いでいた処理を1つのモデルにまとめています。価格は音声レイヤーが1分あたり0.05ドル。音声エージェントを自前のパイプラインで組んでいるチームにとっては、構成そのものを見直す材料になります。
ただし、対応言語の一覧は公開されていません。日本語で実用になるかどうかは、現時点では自分で試して判断するしかありません。
三段構成をやめると何が変わるか
従来のカスケード構成は、認識が終わってから考え、考え終わってから話す、という順番でした。この「順番」が、人間の会話では不自然な間として出ます。相手が話し終わる前に相槌を打てない、考えている最中の沈黙を埋められない、途中で遮られたときに崩れる、といった症状です。
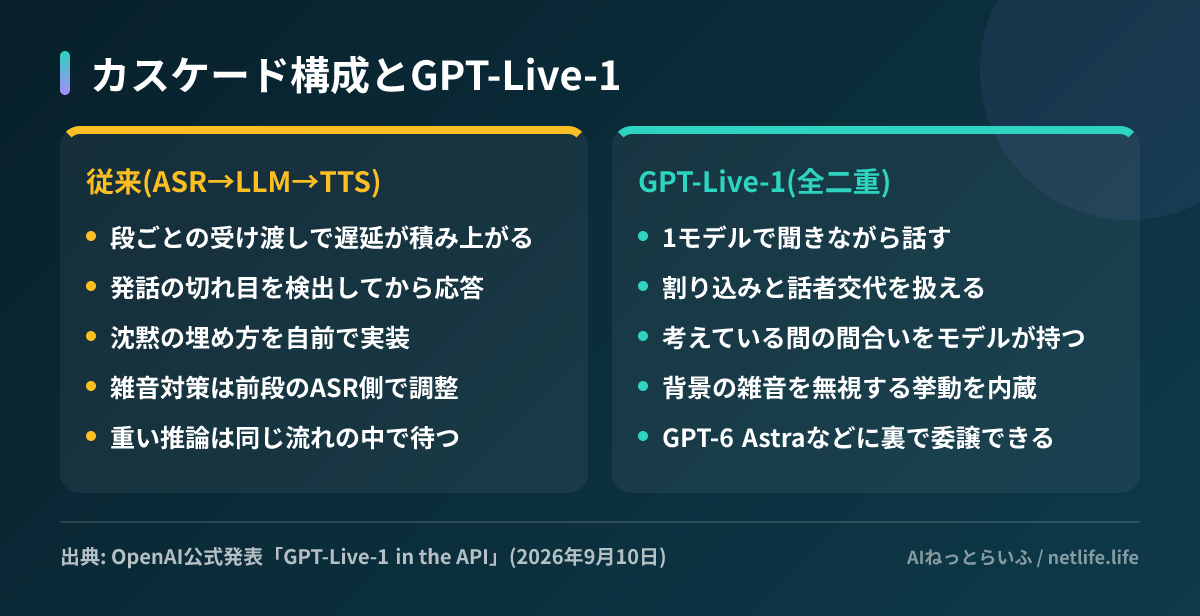
OpenAIが挙げている数値は2つです。会話の同時性を測るFull Duplex Benchで、前世代のGPT-Realtime-2.1より30ポイント改善。そしてGPT-6 Astraを推論強度mediumで組み合わせた構成が、エンドツーエンドの音声エージェント能力を測るTau3で1位だとしています。いずれもOpenAI自身の計測で、第三者による再現は今のところありません。
導入事例として、語学学習のSpeakが「ターン制の従来システムと比べて割り込みを約80%削減した」、別の開発者が「カスケード構成と比べてコードベースを80%簡素化し、2万3千行を削除した」というコメントが紹介されています。2万3千行という数字は、音声エージェントの実装の大半が「モデルの賢さ」ではなく「繋ぎこみ」に費やされてきたことを示していると考えられます。
機能面では、電話(telephony)経由での利用、英数字の聞き取り精度とキーワードバイアス、ネイティブのASRトランスクリプト取得が挙げられています。音声はQuartz、Ripple、Vesperなど、アクセントや方言を広げた新しい選択肢が追加されました。
日本から使うときの見方
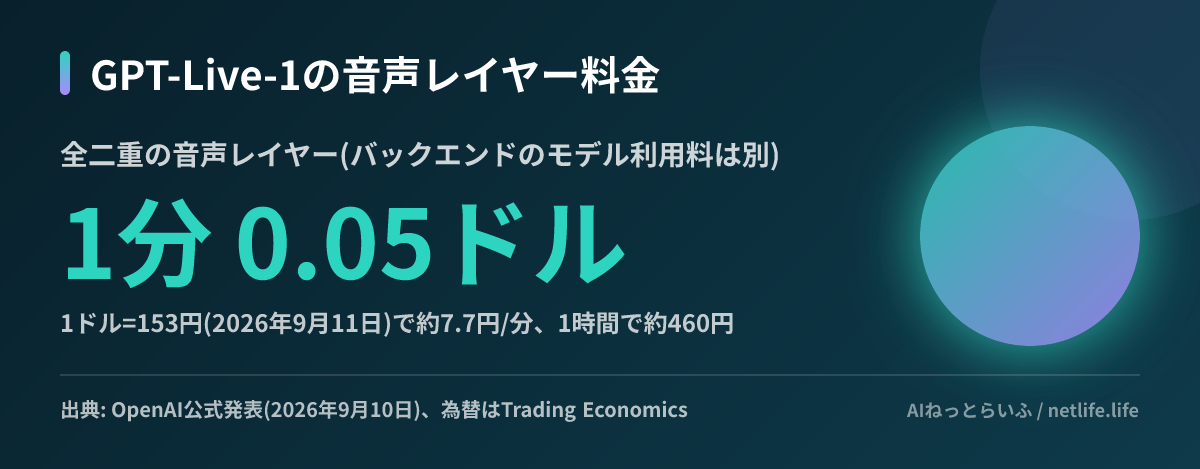
価格から見ます。音声レイヤーの1分0.05ドルは、1ドル153円(2026年9月11日時点)で換算すると約7.7円、1時間で約460円です。裏で走らせるモデルの利用料は別なので、GPT-6 Astraに推論を委譲する構成では合算で考える必要があります。コールセンターのように分単位で積み上がる用途では、通話1件の平均秒数を先に出しておかないと見積もりがぶれます。
文字起こし用途と混同しないほうがよい点もあります。1時間0.10ドルのMAI-Transcribe-2のような音声認識専用モデルとは、桁が違うのは当然で、役割が違います。録音を後から書き起こすならASR専用モデル、その場で会話を成立させるならGPT-Live-1、という分け方になります。
そして日本語です。OpenAIの発表は「アクセント・方言・言語にわたって選択肢を広げる」「今後数か月で音声の選択肢と対応言語を拡大していく」と書いており、現時点で対応している言語の一覧は示されていません。サンプルとして明示されているのはオーストラリア英語の音声です。日本語の応答品質、固有名詞や住所の聞き取り、敬語の扱いについては、発表からは判断できません。国内で導入を検討するなら、実際の通話ログに近い音声で小規模に試すのが先になります。
次にやること
- 既存の音声パイプラインで「繋ぎこみ」に当たるコード(VAD、割り込み制御、間合いの調整)の行数を数え、置き換えの対象を見積もる
- 日本語の通話音声で短いプロトタイプを作り、固有名詞・数字・住所の聞き取りと、割り込まれたときの復帰を確認する
- 分単位課金を前提に、想定通話時間 × 件数で月額を先に出し、バックエンドモデルのトークン費用を別枠で足しておく