Cohereは2026年9月30日、検索用の埋め込みモデル「 Embed 5 」を公開しました。高精度のProと処理の速いFastの2種類で、文字・グラフ・表が混在するPDFのページを、テキスト抽出せずに1つのベクトルとして扱えます。社内文書を検索してAIに回答させるRAG(検索拡張生成)を作っている開発者にとっては、図表の多い資料の検索精度と、ベクトルを保存するコストの両方に効く更新です。ただし日本語の精度ではGoogleのGemini Embedding 2を下回っており、乗り換えるかどうかは自社データで比べてから決めるのが妥当です。
埋め込みモデルとは何か、なぜ今更新なのか
埋め込みモデルは、文章や画像を数百〜数千個の数値の並び(ベクトル)に変換し、意味の近いもの同士を探せるようにする仕組みです。RAGでは、質問に近い資料をここで選び、その資料をもとにLLM(大規模言語モデル)が回答します。検索で外れた資料を拾えば、どれほど賢いLLMでも正しく答えられません。
企業の資料は、決算資料や製品カタログのように表やグラフが多く、文字だけを抜き出すと意味が崩れがちです。Cohereはこうした「ノイズが多く、多言語で、マルチモーダル(複数の種類のデータが混ざった状態)の企業データ」を主な対象に据えています。前世代のEmbed 4に比べて、図表入り文書の検索ベンチマークViDoRe V3で8.8ポイント、多言語の平均で約7ポイント伸びたとしています。
ProとFastの違い
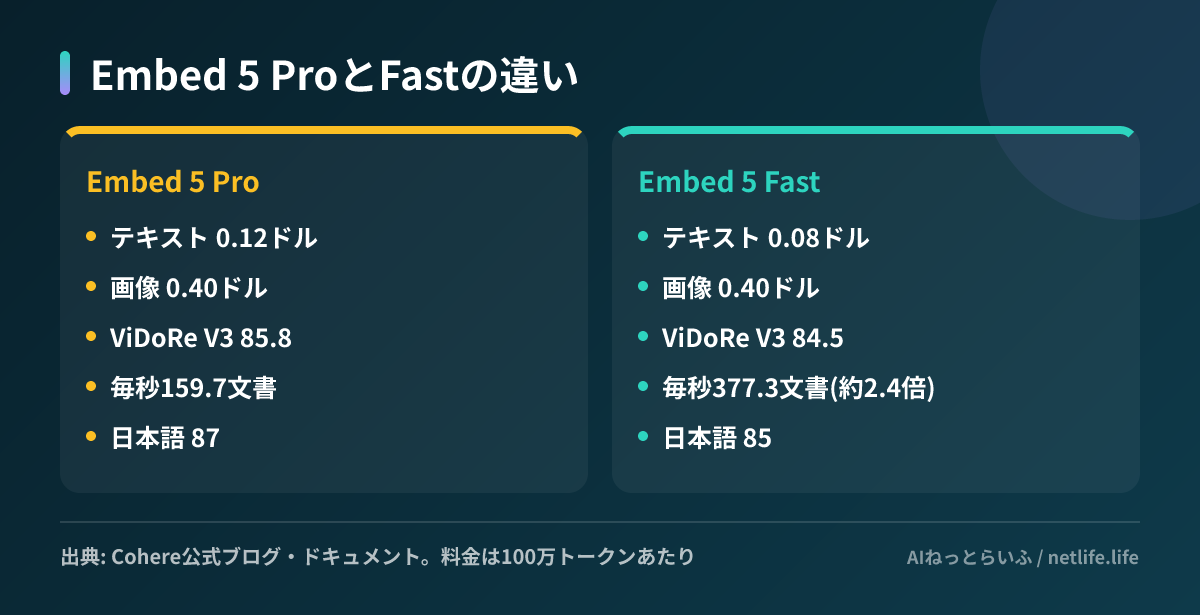
どちらも文脈長は12万8,000トークンで、出力するベクトルの次元数は256〜2048から選べます。Matryoshka(マトリョーシカ)方式という、ベクトルの先頭部分だけを切り出しても意味が保たれる学習をしているため、精度と保存容量を後から調整できます。
興味深いのは、ProとFastが同じベクトル空間を共有している点です。Cohereは「Proで索引を作り、Fastで検索する」構成を勧めています。資料の登録は一度きりなので精度の高いProで行い、利用者が毎回投げる検索文は速いFastで変換する、という分担です。モデルを切り替えても索引を作り直さずに済みます。
保存コストは最大256分の1に
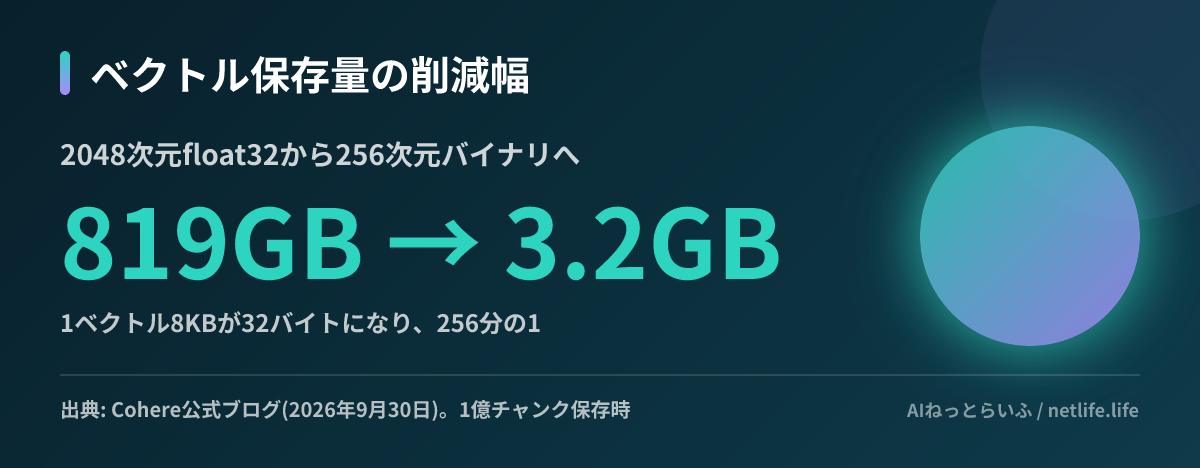
ベクトルの形式はfloat(浮動小数点)、int8(8ビット整数)、binary(1ビット)を選べます。Cohereの試算では、2048次元のfloat32は1ベクトル8KB、1024次元のint8なら1KB、256次元のbinaryなら32バイトです。1億チャンクを保存する場合、約819GBが3.2GBまで減ります。もちろん次元と精度を削れば検索精度は下がるので、どこまで削れるかは自社のデータで測る必要があります。
日本の利用者にとって
日本語の評価値は、複数のベンチマークの平均でProが87、Fastが85でした。同じ表でGemini Embedding 2は90、Voyage 4 Largeは87です。図表入り文書の検索ではEmbed 5が上位に立つ一方、日本語のテキスト検索に限ればGeminiが3点上回っており、「日本語ならEmbed 5が最良」とは言えません。日本語と英語が混在する資料や、表・グラフの多い資料が多い組織ほど、試す価値があると考えられます。
提供はCohereのAPIのほか、Microsoft Foundry、Amazon SageMaker、専用環境のModel Vault、vLLMを使った自社環境やVPC(仮想プライベートクラウド)への導入です。データを国外に出せない企業でも、自社環境で動かす選択肢があります。料金を円換算すると(1ドル150円)、Proのテキストは100万トークンあたり18円、Fastは12円です。モデルIDはembed-v5.0-proとembed-v5.0-fastです。
Embed 4から移る場合はハマりどころがあります。 公式ドキュメント によると、既定の次元数がEmbed 4の1536からEmbed 5では2048に変わっています。次元数を指定せずにモデル名だけ差し替えると、ベクトルDB側の列定義と合わずにエラーになる可能性があります。またEmbed 4とベクトル空間を共有するという記載はないため、索引は作り直す前提で計画するべきです。
次にやること
- 既存のRAGで検索に失敗している質問を20〜50件集め、現在の埋め込みモデルとEmbed 5、Gemini Embedding 2で上位10件の正答率を比べる
- 図表の多いPDFは、テキスト抽出版とページ画像版の両方で索引を作り、どちらが当たるかを確認する
- ベクトルDBの容量が課題なら、1024次元int8や256次元binaryで精度がどこまで落ちるかを測ってから設定を決める