
米国のNSA(国家安全保障局)、FBI(連邦捜査局)、CISA(サイバーセキュリティ・インフラセキュリティ庁)は2026年9月8日、中国を拠点とするAI企業が米国のフロンティアモデルから「産業規模」で能力を抜き出しているとする共同サイバーセキュリティ助言(AA26-251A)を公表しました。焦点は不正アクセスではなく、正規の商用APIを大量に使う「蒸留(distillation)」です。中国製オープンウェイトモデルを検討している国内企業と、自社でLLM APIを提供している事業者の双方に、確認すべき点が生まれました。
何が問題視されているのか
蒸留とは、高性能なモデルの出力を教師データとして別のモデルを学習させる、AI開発では標準的な手法です。問題視されているのはその手法自体ではなく、規模と経路です。助言は、対象企業が「制限された独自機能を系統的に抜き出す、攻撃的で産業規模の蒸留活動」を行っていると表現し、これによって中国側が計算資源・電力・基礎研究への巨額投資を回避しながら技術差を詰めていると指摘しています。NSAの発表文は、こうした能力向上が「米国と同盟国に対して使われうる軍事・サイバー攻撃能力を強化する」とも述べています。日本は文中の「同盟国」に含まれる立場です。
助言文書の内容を伝えるHelp Net Securityの報道によると、名指しされたのはDeepSeek、Moonshot AI、Alibaba、MiniMax、StepFun、Z.AIの6社です。DeepSeekはR1およびV3の学習に、Moonshot AIは2025年半ば以降のKimiの改良に用いたとされ、残る各社はコーディング・推論・エージェント能力の開発に使ったと整理されています。抜き出された側はClaude、GPT、Gemini、Grokの各系列で、2024年末以降に数十億トークン規模が引き出されたという見立てです。各当局は、この活動が中国政府の認識のもとで行われた可能性が高いと評価しています。
なお、これはあくまで米当局の評価であり、司法手続きで認定された事実ではありません。また「モデルに脆弱性がある」という指摘でもない点は分けて読む必要があります。
なぜ「今」なのか
背景には、上位モデルの学習コストと、公開されたモデルの性能が急速に近づいてきた事情があります。DeepSeekやZ.AI(智譜)は重みを公開する路線を取っており、DeepSeek V4系の重み公開やGLM-5.3-Flashのように、無償または安価で使える選択肢として日本でも実務投入が進みました。米当局の関心は、その性能がどこから来たのかという点にあります。
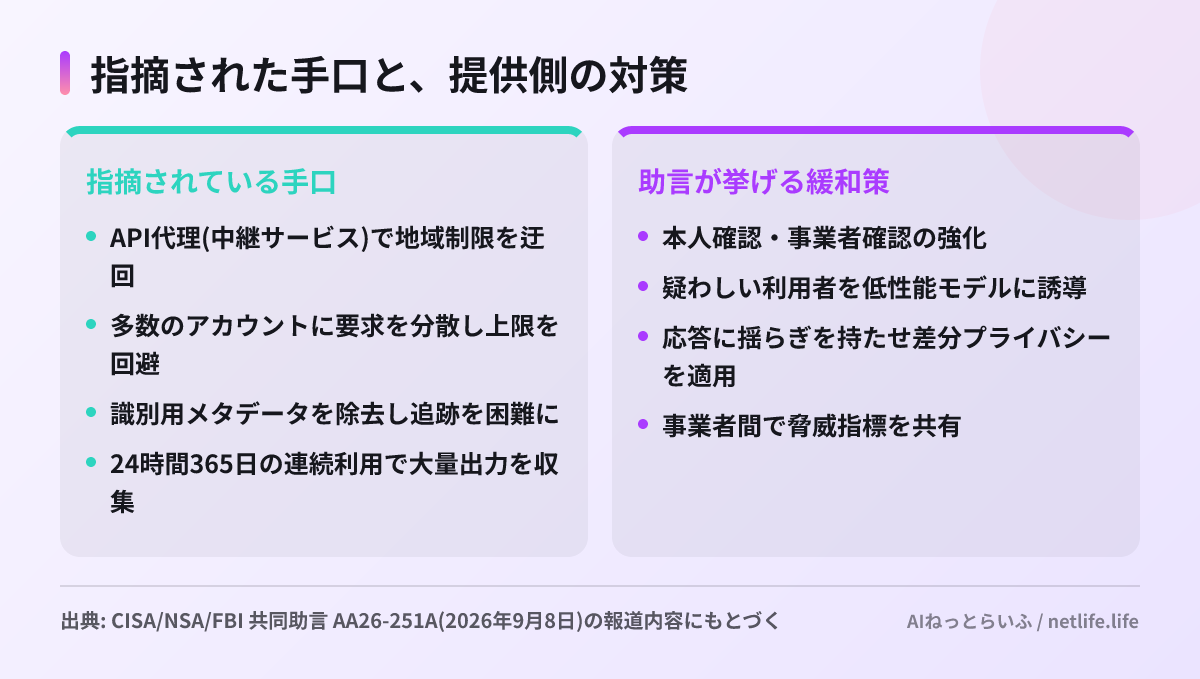
もう一つの理由は、防御の主戦場がモデル提供側の運用に移ったことです。助言は、クラウド事業者、API集約サービス(アグリゲーター)、インフラ運用者を含むエコシステム全体での連携を求めています。検知の手がかりとして挙がっているのは、休みのない連続利用、契約プランに対して不自然な利用比率、複数アカウントにまたがる協調的な挙動です。個々のアカウントを見ても異常に見えないため、横断的な相関分析が要になる、という整理です。
日本の読者にとって
まず、中国製モデルを使っている、あるいは検討している企業への影響です。今回の助言は利用禁止を求めるものではなく、モデルの安全性そのものを問題にしたものでもありません。ただし調達の意思決定に「供給元の法的リスク」という軸が一段重くなったのは確かです。米国のモデル提供各社は利用規約で「出力を競合モデルの学習に使うこと」を禁じているのが一般的で、今後この条項をめぐる紛争が起きた場合、派生モデルを業務に組み込んでいる側にも間接的な影響が及ぶ可能性があります。現時点で慌てて乗り換える理由は乏しいものの、契約書に代替手段への切り替え条項があるかは確認しておく価値があります。
次に、自社でLLM APIやAIサービスを提供している事業者への影響です。助言が挙げる緩和策は、そのまま一般的なAPI濫用対策として使えます。応答に揺らぎを持たせる、疑わしい利用者を低性能モデルに回す、といった手法は、蒸留対策に限らず、無断スクレイピングや競合による大量収集への備えにもなります。特にアカウント単位ではなく利用パターンの相関で見る発想は、既存のレート制限だけでは拾えない挙動を捉えるものです。
そして、自社が蒸留する側になっていないかという点も見ておくべきです。商用APIの出力で社内モデルを学習させる構成は、コスト削減策として国内でも検討されますが、多くの規約で明確に禁止されています。当局が問題視する規模とは桁が違うとしても、契約違反の判断は規模ではなく行為で決まります。
次にやることを3つ挙げます。第一に、中国製モデルを本番で使っている場合、供給停止や規制強化が起きたときの切り替え先と所要期間を書き出しておくこと。第二に、AI APIを外部提供しているなら、アカウント横断で連続利用・不自然なプラン利用比率を検知するクエリを一本用意すること。第三に、社内でモデル学習に外部APIの出力を使っている箇所がないかを棚卸しし、該当すれば利用規約と突き合わせることです。


