Googleは2026年9月23日、テキストを音声に変換するTTS(Text-to-Speech、音声合成)モデル「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」をGemini APIとGoogle AI Studioで公開しました。文章で指示して新しい声を作る「ボイスデザイン」、30秒の音声サンプルから同じ声を再現する「声の複製」、2,000以上の既製ボイスを1つのモデルで扱えます。価格は年内の出力単価が旧モデルの半分以下で、1時間の音声を作っても1ドルに届きません。ナレーション、オーディオブック、音声エージェントを作っている人に関係する発表です。
何ができるようになったか
これまでのGeminiのTTSは、用意された声を選び、話し方を指示する使い方が中心でした。今回は「声そのもの」を作る・持ち込む機能が加わっています。公式ブログが挙げている機能を整理すると次のとおりです。
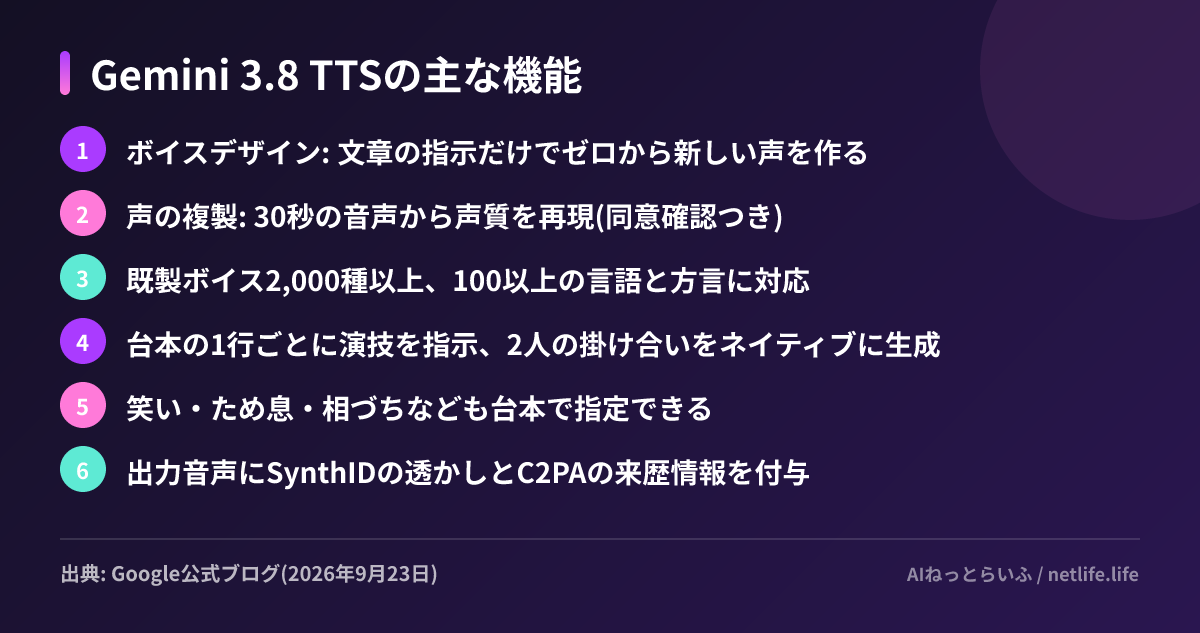
長尺への強さも前面に出しています。Googleは両モデルについて「何時間もの連続した音声でも声質や話すテンポを保ち、話者のぶれが少ない」と説明しており、ポッドキャストやオーディオブックを想定しています。第三者評価では、Hume AIのボイスデザイン評価で総合1位(71.4)、音声を聞き比べて投票するVoice Arenaでは日本語、ブラジルポルトガル語、ヒンディー語などで上位に入ったとしています。
2つのモデルは役割で分かれています。Flash TTSはキャラクターの声作りや演技指示など表現寄りの用途、Flash-Lite TTSは吹き替えや音声エージェントのような大量処理をコストを抑えて回す用途です。提供面も分かれていて、Flash TTSはGemini Notebook、Flash-Lite TTSはGoogle Vidsにすでに組み込まれ、企業向けのGemini Enterpriseには両方とも「近日提供」とされています。
なぜ今、声の複製まで踏み込んだのか
背景には、音声モデルをめぐる競争の変化があります。9月だけでもOpenAIが全二重の音声モデルGPT-Live-1をAPIで出し、Google自身もGemini 3.8 Liveで「話しながら考える」音声対話モデルを出しました。対話型の音声は各社がそろいつつある一方、ナレーションや吹き替えのように「決まった台本を狙った声で読む」領域は、声の複製やボイスデザインに強い専業ベンダーが先行していました。今回の発表は、その領域を汎用APIの一機能として取り込みにいく動きと見ることができます。
同時に、声の複製は悪用の余地が大きい機能です。Googleは複製の対象を「自分の声か、使用権を持つ声」に限り、組み込みの同意確認を必須にしています。さらにAI Studioでの声の複製は、イリノイ州とテキサス州、EEA(欧州経済領域)、英国、スイス、インドでは使えません。生体情報や声の権利に関する規制がある地域を外した形と考えられます。
料金は年内が半額、1時間あたり約0.8ドル
Gemini APIの料金表では、100万トークンあたりの出力(音声)単価がFlash TTSで9ドル、Flash-Lite TTSで6ドルです。ただしこれは2026年12月31日までの価格で、2027年1月1日からはそれぞれ18ドル、12ドルに上がります。入力(テキスト)は両方とも0.5ドル(2027年から1ドル)で、無料枠もあります。
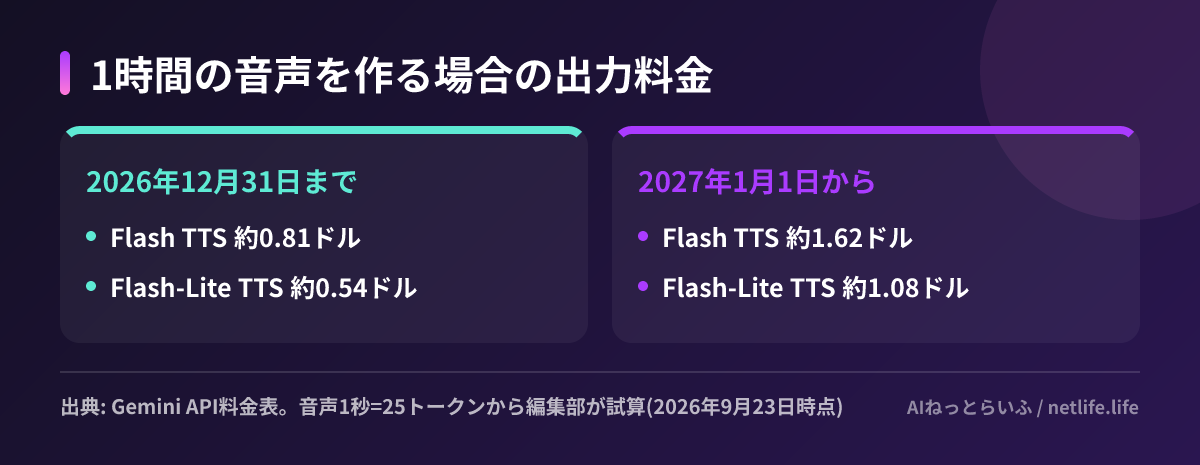
料金表には「音声1秒=25トークン」と書かれているので、1分は1,500トークン、1時間は9万トークンになります。ここから計算すると、Flash TTSで1時間分の音声を作る出力料金は約0.81ドル、1ドル=150円で約120円です。旧モデルの3.1 Flash TTS Previewは出力20ドルだったため、年内は半額以下、値上げ後でも1割ほど安い水準です。テキスト入力の料金は、1時間分の原稿でも数円程度にとどまる計算です。
日本の読者にとって
まず、日本は声の複製の制限地域に含まれていません。公式の一覧を見る限り、日本からはAI Studioで声の複製を試せると考えられます。ただし、使えることと使ってよいことは別です。他人の声を本人の許可なく再現すれば、日本でもパブリシティ権や肖像権に近い問題になりえますし、声優・ナレーターとの契約で合成音声の利用範囲を定めている現場も増えています。社内の担当者やナレーターの声を使う場合は、利用目的と範囲を書面で合意してから試すのが安全です。
日本語の品質については、Voice Arenaで上位に入ったという記載が数少ない手がかりです。一方、読み間違えやすい固有名詞、数字、英語混じりの型番をどこまで正しく読めるかは公開されていません。社内マニュアルや製品名を読ませる用途では、実際の原稿で確認が必要です。
実装面の制約もあります。モデルカードでは入力が最大8,000トークン、出力が最大6万4,000トークンです。音声1秒=25トークンで割ると、1回のリクエストで作れるのは最大42分ほどになります。オーディオブックのように長いものは、章ごとに分けて生成し、同じボイス設定で声をそろえる設計になります。
次に試すこと
- AI Studioの音声生成画面で、自社の実際の原稿(固有名詞や数字を含むもの)を読ませ、日本語の読み間違いを確認する
- 既存の音声合成サービスを使っている場合は、月間の生成分数に上の単価を掛けて比較する。2027年1月の値上げ後の価格で試算しておく
- 声の複製を使うなら、対象者の同意の取り方と、生成音声を使う範囲(社内のみか、広告にも使うか)を先に決めておく