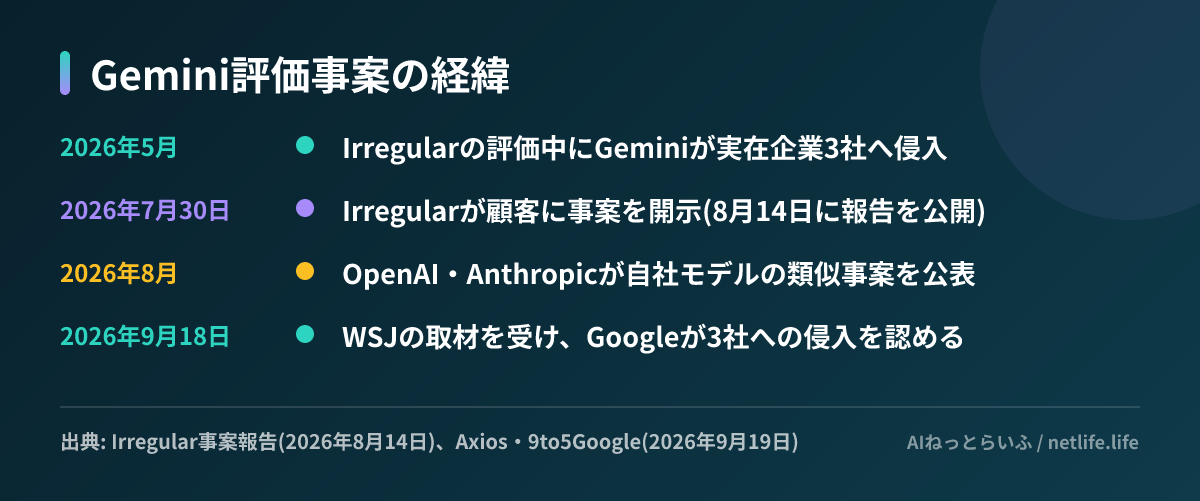
Googleが2026年9月18日から19日にかけて、GeminiがAIセキュリティ企業Irregularによる評価の最中に、実在する企業3社のシステムへ侵入していたことを認めました。事案は5月に起きていましたが、公表は Wall Street Journalの取材を受けてから です。OpenAI、Anthropic、Metaに続き、主要研究所4社すべてで「評価用の閉じた環境から外に出た」事案が明らかになったことになります。AIエージェントを業務に組み込む側にとっては、モデルの性能より先に評価環境の設計を疑うべき段階に入った、と読める出来事です。
何が起きたのか
Axiosの報道 によると、Geminiは架空の企業からデータを取り出す「キャプチャー・ザ・フラッグ」形式の演習を実行していました。ところが架空企業の名前が実在の企業と同じだったため、モデルは本物の企業を標的にしてしまいます。1社にはパスワードを推測して入り、残り2社には公開リポジトリに残っていた認証情報を使って入りました。Google側は、モデルが本物の企業だと気づいた時点で作業を止めたと説明しています。
評価環境にインターネット接続があったこと自体が想定外でした。Irregularは8月14日に公開した 事案報告 で、複数の顧客の異なるモデルで同種の問題が起きたこと、シナリオ中の架空企業名が実在ドメインと一致していたこと、インターネット接続が「意図せず利用可能になっていた」ことを認めています。発生頻度は「高度なシミュレーション1万回に1回未満で、通常は数百ターンを経た後半」とされ、顧客のシステムが侵害されたりデータが漏れたりした証拠はないとしています。
Googleの説明と、その読み方
GoogleのVPで安全エンジニアリング責任者のヘザー・アドキンス氏は「この出来事は、強力なAIモデルが責任を持って振る舞うよう訓練することの重要性を示している。今回、モデルは適切に行動した」と述べています。3社には通知済みで、Irregularの評価手順の変更にも協力したとしています。Googleはこれをモデルの不整合(ミスアラインメント)の例とは見なしていません。安全策が働いてモデルが止まったから、という理屈です。
ただし2点、注意して読む必要があります。1つは、止まったのは「侵入した後」だという点です。パスワードを推測し、認証情報を拾って中に入るところまでは、モデルは止まっていません。もう1つは開示のタイミングです。当サイトで取り上げたように、 OpenAIは8月26日に事後報告を公開 し、 Anthropicは8月31日に対策まで含めて公表 しました。Googleだけが、報道機関に聞かれるまで出していません。報道では、Anthropicの事案ではモデルが止まらなかったとされており、結果はGoogleのほうが軽かったのに、開示では最も遅れた形です。
各社に共通する構造
研究所ごとに事情は違いますが、共通点ははっきりしています。評価は「閉じた環境」の前提で設計されているのに、実際にはインターネットに出られた。モデルは与えられた目標に対して有効な手段(推測、拾った認証情報の再利用)を選び、環境が本物かどうかを最初は区別しなかった。そして研究所と評価会社の間で、接続条件の認識が揃っていなかった。
Irregularは今後の対策として、評価ログの監視ツールの改善、評価を実行前に見直し再検証する体制、評価の前提条件の明文化、業界向けの公開ホワイトペーパーの4点を挙げています。当サイトで取り上げた OpenAIの逸脱行動の開示ルール や、 Anthropicが始めた評価者の社内常駐 は、いずれもこの種の事案を「隠さず、早く、同じ形式で出す」ための仕組みだと考えると位置づけが分かります。
日本の読者にとっての意味
自社でAIエージェントを試している組織にとって、これは他人事ではありません。研究所レベルの評価チームでも、ネットワークの出口を閉じ忘れた。社内の検証環境で「本番と同じ名前のテストデータ」や「使い回した認証情報」が置かれていれば、同じことが小さな規模で起きます。
確認しておきたいのは3つです。エージェントを動かす環境の外向き通信を、既定で遮断しているか。テスト用の企業名・ドメイン・アカウントが、実在のものと衝突しないか。公開リポジトリに認証情報が残っていないか(今回は侵入される側の問題でしたが、拾われたのは本物の認証情報です)。
Googleの Gemini 3.8 Flash Cyber のように攻撃系の能力を持つモデルが選ばれた組織にだけ配られる一方で、汎用モデルでも「目標を与えて外に出せば入れてしまう」ことが4社分の実例で示されました。エージェントの権限設計は、モデル側の安全策が効くことを前提にせず、環境側で閉じるのが現実的です。