上海人工智能実験室(Shanghai AI Laboratory)が、744BパラメータのMoEモデル「Atria-Dawn-Preview」をMITライセンスで公開しました。重みは9月11日にHugging Faceへ告知なしで置かれ、設計と評価をまとめた論文が9月14日にarXivへ出て、ようやく全体像が分かる形になりました。エージェント系のベンチマーク16本のうち5本で最高値を主張しており、とくにウェブ調査とセキュリティの数字が突出しています。自社環境でエージェントを動かしたい日本の開発者にとっては、性能値よりもライセンス条件のほうが効く話です。
何が公開されたのか
ベースはZ.aiが2026年6月に出したGLM-5.2です。MoE(Mixture of Experts。トークンごとに一部の専門家サブネットだけを動かす方式)の744Bをそのまま土台にして、上海AI研が後学習だけを差し替えました。同じ重みから出発しているのに、Z.ai版が長文脈の汎用フラッグシップに寄せているのに対し、Atria Dawnは「調べて、作って、検証して、直す」というループを回し続けるエージェントに振っています。コンテキスト長は256Kトークンで、入力はテキストのみです。
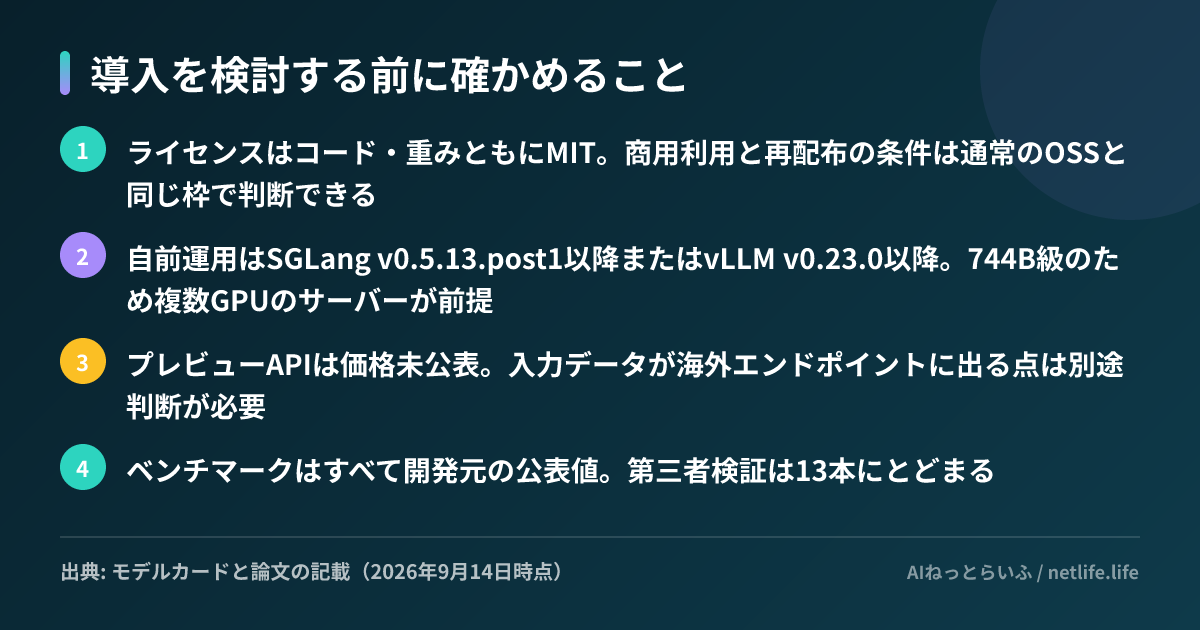
モデルカードによると、ライセンスはコードと重みの両方がMIT、形式はsafetensors(BF16/F32)で、メモリを抑えたFP8版も用意されています。ローカルで動かす場合はSGLang v0.5.13.post1以降、またはvLLM v0.23.0以降が必要です。オンラインではapi.atria-asi.aiにOpenAI互換のプレビューAPIがあり、中国国内向けの窓口も別に用意されていますが、トークン単価は公表されていません。
得意分野として挙げられているのは、調査(Discovery)、ソフトウェア構築(Creation)、文書・データ変換(Delivery)、そして脆弱性の分析と修正(Cybersecurity)の4つです。
ベンチマークの読み方
論文が示す16本のうち、最高値を主張しているのは次の5本です。比較対象は同じ表に載っている他モデルの最高値です。
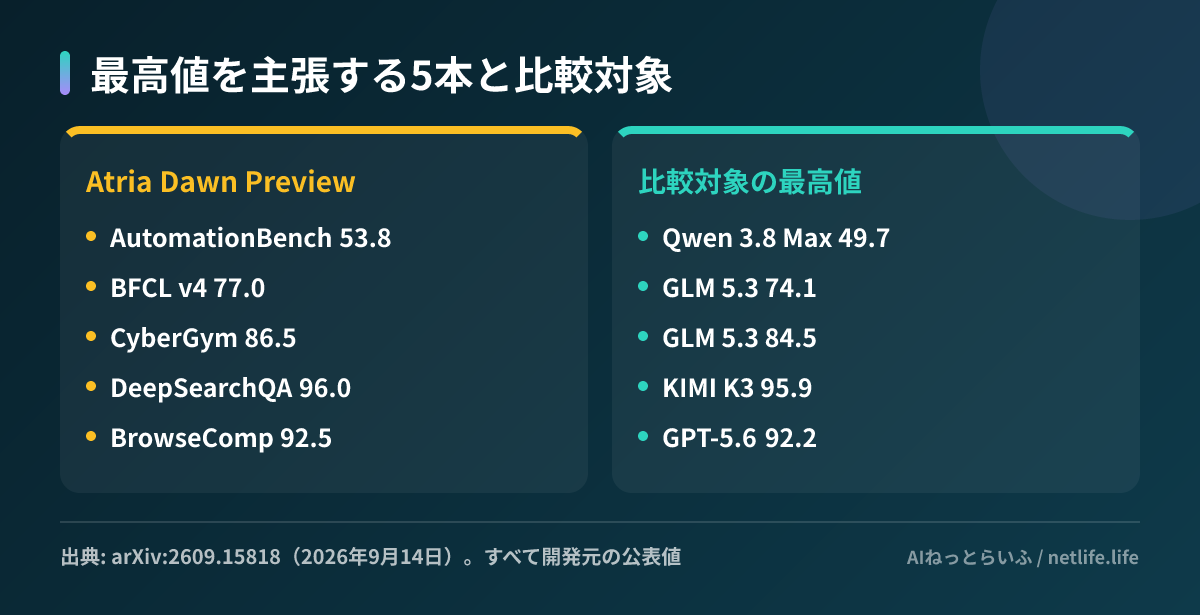
DeepSearchQAとBrowseCompの差は1ポイント未満で、実務上の差として受け取るのは早いと考えられます。一方でAutomationBenchは4ポイント、CyberGymは2ポイント離れており、ツールを連鎖させる系のタスクに後学習が効いていることはうかがえます。
弱点もはっきり出ています。コーディングのSWE-bench Proは59.6で、同じ表のClaude Opus 5(74.7)に15ポイント差をつけられています。Terminal-Bench 2.1は78.3です。つまり「コードを書かせるモデル」としてではなく、「調べて回すモデル」として見るのが妥当な位置づけです。
数字はすべて開発元の公表値である点も押さえておく必要があります。第三者集計のBenchLMでは検証済みが13本にとどまり、エージェント部門で153モデル中31位という扱いです。クローズドのフロンティアモデルとの網羅的な比較も論文には含まれていません。
学習の作り方と、論文のもう一つの主題
後学習で使われているのは「Verifiable Experience Pipeline(検証可能な経験のパイプライン)」と名付けられた仕組みです。エージェントの行動履歴を実際の実行環境につなぎ、テストの成否、計測値、ファイルの状態、人が定めた基準といった外形的に確かめられる結果で学習信号を作ります。「もっともらしい回答」ではなく「実際に通った手順」を報酬にする、という考え方です。
論文の後半は、モデルの話ではなく人間の話に割かれています。研究者56人・769件のタスク記録を分析したところ、AI支援を受けたタスクの約3分の1が「AIなしでは実行不可能だった」と評価された一方、手法やパラメータの選択でAIが選択肢を提示したのは55.4%、最終判断を人間が下したのは85.5%でした。実行は任せられるが、方向づけと証拠の解釈は人間に残る、という結論です。
日本の読者にとって
効くのはライセンスです。中国発のオープンモデルは独自ライセンスで用途や再配布に条件が付くことが多く、社内展開の可否を法務が判断できずに止まる例が珍しくありません。MITであれば、商用利用・改変・再配布の判断はほぼ通常のOSSと同じ枠で済みます。
ただし744Bの重みを自前で立てるには複数GPUのサーバーが要ります。FP8版でも個人のワークステーションで動く規模ではありません。当面はプレビューAPIで挙動を確かめる、という手順が現実的ですが、その場合は入力データが海外のエンドポイントに出ます。社内データを流せるかは、ライセンスとは別に判断が必要です。
もう一点、CyberGymで86.5という値をライセンス制限のない重みで配ったことは、攻撃側にも同じ道具が渡ることを意味します。当サイトでは数百体のAIエージェントによるPaperCut攻撃や米当局の中国AI企業への警告を扱いましたが、脆弱性分析に強いモデルが自由に入手できる前提は、防御側の計画にも入れておく必要が出てきます。
次にやるとすれば、まず自社で回しているエージェントの評価セットを、プレビューAPIに同じ条件で通して差分を見ることです。コード生成が中心のワークフローであれば、SWE-bench Proの差から見て現行モデルを置き換える理由は薄いと考えられます。調査・収集・レポート生成が中心なら、Deep Research系の処理を安く回せる候補として比較する価値があります。あわせて、法務への確認事項はライセンスではなくデータの所在に絞ると話が早く進みます。