Anthropicは2026年11月12日(米国時間)、AIエージェントの実行基盤「Claude Managed Agents」を、サービスごと自社のクラウドやオンプレミス環境で動かせるセルフホスト版の非公開ベータを始めました。エージェントの制御ループ、コードを実行する隔離環境(サンドボックス)、認証情報、会話履歴がすべて自社の管理下に置かれます。社外のSaaSにデータを置けないことがエージェント導入の壁になっていた、金融などの規制業種の企業に関係する発表と考えられます。利用にはAnthropicの営業担当への申し込みが必要です。
何が自社側に移るのか
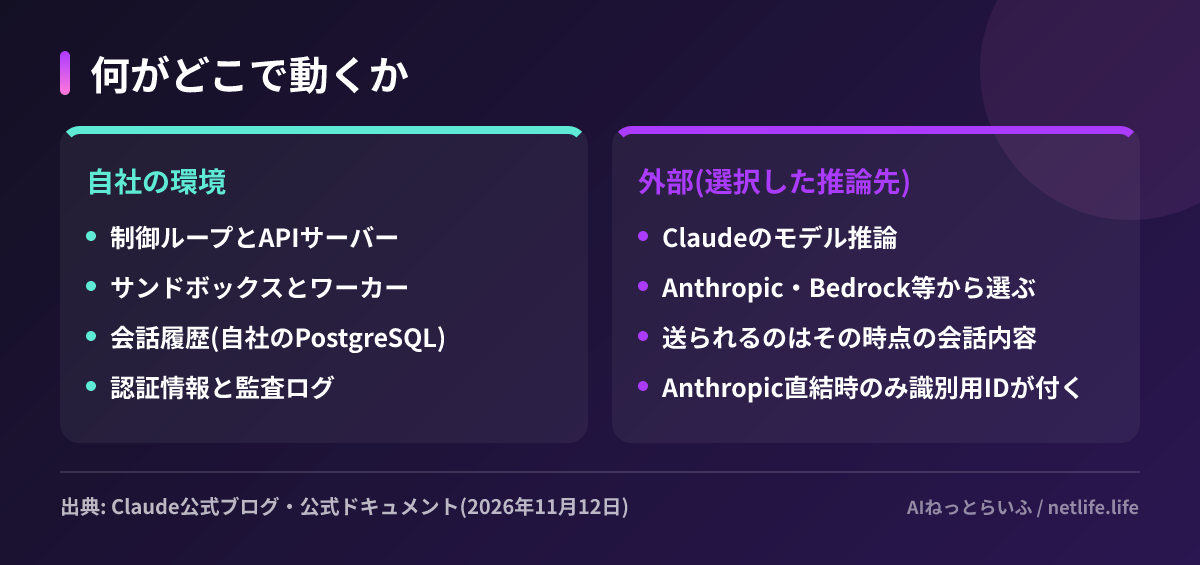
Managed Agentsは、Claudeに道具を持たせて長い作業を任せるためのAnthropicのホスト型サービスです。これまでも「サンドボックスだけ自社で動かす」構成はありましたが、今回はAPIサーバーやデータベースを含むサービス全体を自社に置けるようになりました。開発者が使うAPIはホスト版と同じです。
公式ドキュメントによると、構成は次の部品からなります。
- サーバー(cma-server): API、エージェントの制御ループ、セッション履歴の保存、モデル呼び出しを担う。シェルやファイル操作は実行しない
- データベース: PostgreSQL 16以降。指定しないとメモリ上に保存され、再起動で消える
- ワーカー: サーバーから仕事を受け取り、サンドボックス内でシェルとファイル操作を実行する
- 管理画面: サーバー上で動くWeb画面。自社のIDプロバイダー経由でログインする
配置はDocker ComposeかKubernetes(Helmチャート)で、Kubernetesではセッションごとに専用のPodが立ちます。
なぜ今セルフホストなのか
AIエージェントは、社内のコードやデータベースに触れ、外部のAPIを呼び出します。会話履歴には顧客情報やソースコードがそのまま残るため、「どこに保存されるか」が導入審査の最大の論点になりがちでした。AnthropicはOpenAIやGoogleと企業向けエージェント基盤で競っており、規制の厳しい業界を取り込むには自社環境で動く選択肢が必要だったと考えられます。
セキュリティ設計についてAnthropicは4つの原則を挙げています。モデルを呼ぶ側とコードを実行する側を分けること、認証情報をサンドボックスの外に置き、外側のプロキシが付け足すこと、通信先を許可リストで絞ること、すべての操作を記録してOpenTelemetry(監視データの標準形式)で書き出せることです。盗まれたAPIキーが悪用されたRailwayの侵害のように、実行環境に鍵を置かない設計は実務上の意味が大きいところです。
データの流れを説明したページによれば、サーバーがAnthropicに接続するのは推論先にClaude APIを選んだときだけです。推論先はClaude APIのほか、Amazon Bedrock、Google Cloud、Microsoft Foundry、自社のゲートウェイから選べます。ただし推論先に送られるのは、その時点までの会話内容とツールの入出力すべてです。「自社DBに履歴が残る」ことと「外部にデータが出ない」ことは別だと理解しておく必要があります。
ホスト版との違いとつまずきやすい点
ホスト版との違いは細かく列挙されています。導入前に把握しておきたいのは次の点です。
- クラウド型の実行環境、Files API、Webhook、予定実行(scheduled deployments)は使えない。定期実行は自社のcronなどで代替する
- docx・pdf・pptx・xlsxの既製スキルは使えず、ソースを取得してカスタムスキルとして登録し直す
- MCPサーバーとGitの接続先は、設定ファイルの許可リストに書くまで一切つながらない(ワイルドカード不可)
- ワーカーがポーリングしていないと、最初のツール呼び出しでセッションが無言で止まる
- サーバーはforce pushを止めないため、ブランチ保護はGit側で設定する
- ホスト版からの移行機能はなく、エージェントや認証情報は作り直す
運用面では、1つのデプロイを1つのテナント・1つの信頼レベル専用にするよう求めています。部署ごと、あるいは信頼できるコードとできないコードで、データベースごと分ける前提です。
日本の読者にとって
日本の金融機関や官公庁系の案件では、データの保存場所や外部サービス利用の審査が導入の前提になります。会話履歴やログを自社のデータベースと監視基盤に残せるのは、こうした審査を通しやすくする方向の変化です。推論先をBedrockなどのクラウドにすれば、既存のクラウド契約の範囲でモデルを呼べる可能性があります。ただし、各クラウドの東京リージョンでどのClaudeモデルが使えるかは別途確認が必要です。また、推論先によって使える機能が変わります。たとえばWeb検索はBedrockや自社ゲートウェイでは使えず、推論地域の指定(inference_geo)はAnthropic直結のときだけです。
料金は発表に記載がなく、非公開ベータのため一般の開発者がすぐ試せるわけではありません。サーバーとデータベースの運用、リリースごとの更新も利用者側の責任になります。
次にやること
- 社内でエージェント導入が「データの置き場所」で止まっているなら、Anthropicの営業担当に非公開ベータの条件を問い合わせる
- 推論先をどこにするか(Anthropic直結か、既存のクラウド契約か)を先に決め、使えなくなる機能を違いの一覧で確認する
- Webhookや予定実行に依存した設計になっていないか、既存のエージェントを棚卸ししておく