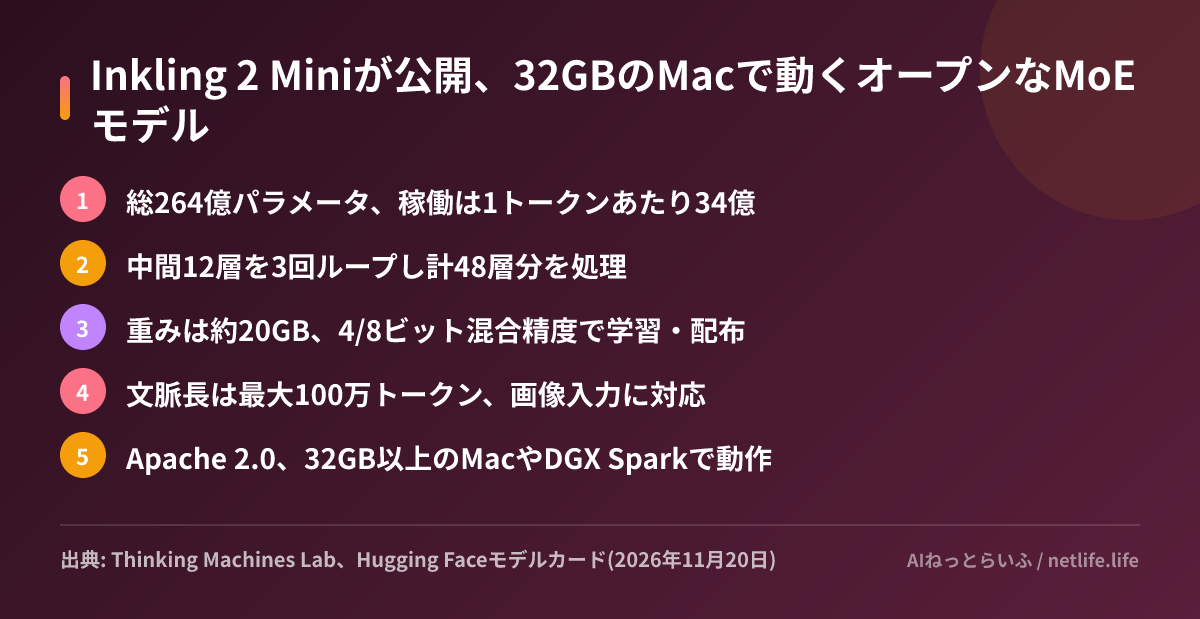
Thinking Machines Labは2026年11月20日(米国時間)、オープンウェイトの言語モデル「Inkling 2 Mini」を公開しました。総パラメータは264億(26.4B)、1トークンの処理で実際に使うのは34億(3.4B)というMoE(専門家混合)モデルで、重みは約20GB。ライセンスはApache 2.0で、ユニファイドメモリ32GB以上のMacやNVIDIA DGX Sparkで動きます。手元のPCや社内サーバーでコーディング用エージェントを動かしたい開発者にとって、同クラスの公開モデルの有力な選択肢が1つ増えた形です。
何が発表されたのか
Hugging Faceのモデルカードによると、文脈長は最大100万トークンで、画像入力にも対応します。重みはHugging Faceで公開され、vLLM、SGLang、Ollama、Unsloth、Docker Model Runnerなどで動かせるほか、llama.cpp向けのGGUF形式の量子化版も用意されています。同社のサービス「Tinker」では推論とファインチューニングが可能です。
特徴は2つあります。1つは「ループ」です。24層のうち中間の12層を1トークンあたり3回繰り返し通すため、計算上は48層分の処理になります。パラメータを増やさずに計算の深さを稼ぐ設計で、繰り返しを含めた実質の稼働量は54億(5.4B)相当とされています。もう1つは、最初から4ビット(NVFP4)と8ビット(MXFP8)の混合精度で学習し、その精度のまま配布している点です。通常は公開後に量子化(精度を落として軽くする処理)するため劣化が出ますが、それが起きない作りです。
なぜ小さいモデルなのか
同社は上位の「Inkling 2 Small」を先に出しており、Miniは同じ系列から専門家(エキスパート)の3分の2を削り、ループを加えて作ったと説明しています。学習の途中で384個あった専門家を128個まで減らし、大きな社内モデルからの蒸留で性能を補っています。狙いは「ノートPCで動く大きさ」と速度です。
背景には、手元で動くエージェント用モデルの競争があります。比較対象として挙げているのはQwen3.8-27BやGemma 4 31Bなど同サイズ帯の公開モデルで、エネルギー効率の指標も前面に出しています。スタンフォード大学の研究者による「Intelligence per Watt」(一定の性能に達するのに必要な電力量)の測定では、DGX Spark上で0.703と、Qwen3.6-35B-A3Bの0.430を上回ったとしています。ただし同社自身、Inkling 2 MiniはMXFP8、他モデルはNVFP4やINT4と条件が違うと注記しています。
ベンチマークの数字と弱点
コーディング系の評価では、同サイズ帯の公開モデルの中で上位の数字が並びます。
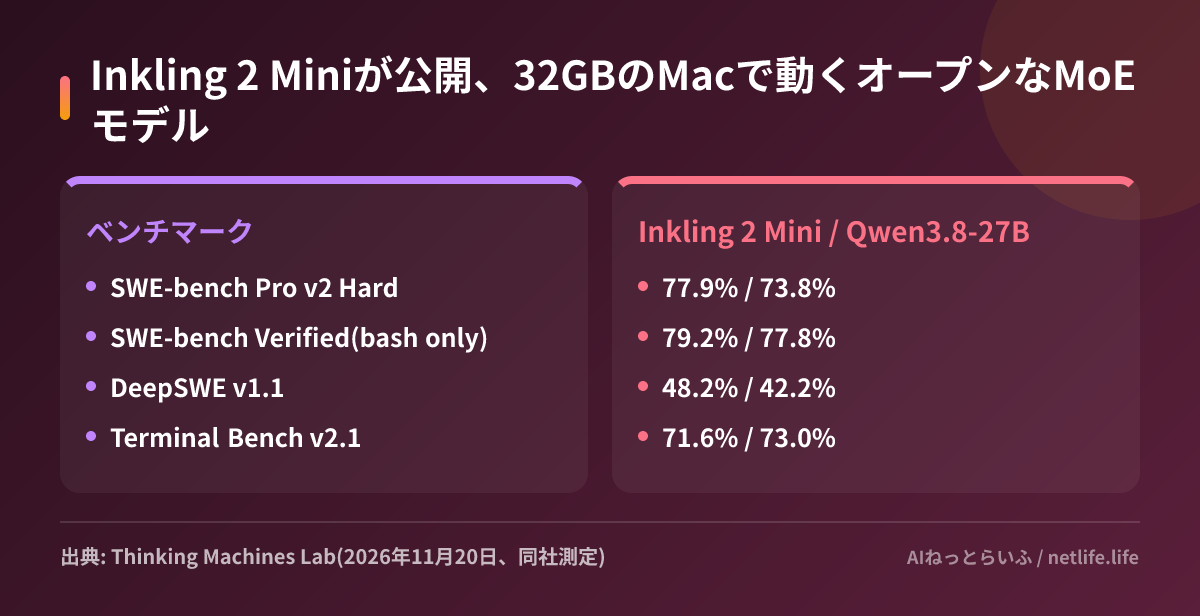
一方、同社は弱点も明記しています。多数の制約を含む指示への追従(ComplexConstraints 33.4%)や複数ターンの会話(MultiChallenge 50.0%)は得意ではなく、知識量はパラメータ数に縛られます。もっともらしい誤り(ハルシネーション)を出さない割合は63.4%で、Qwen3.8-27Bの71.4%を下回りました。社外のコードベースで調べものをさせるより、手元のリポジトリとツールを使って作業させる用途に向いたモデルと考えられます。なお、数字はいずれも同社の測定で、第三者による検証はこれからです。
日本の読者にとって
モデルカードの対応言語は英語と「一般的な多言語対応」で、日本語への言及はありません。英語以外では出力品質が落ちる可能性があり、中国語の試験では言い回しが途切れたり言語が混ざったりしたと書かれています。日本語の文章生成を主目的にするなら、導入前に自社の文章で試す必要があります。
一方で、Apache 2.0は商用利用や改変が認められる緩やかなライセンスです。社外にコードを出せない案件で、ローカルのコーディング支援やエージェントの土台に使う選択肢になり得ます。32GBのMacで動く点は、国内の開発チームで一般的な機材でも試しやすい条件です。ローカル実行の基盤であるllama.cppの最近の動きはllama.cppが初の安定版v1.0.0に、互換性を壊す変更はメジャー版だけにでまとめています。
次にやること
- 32GB以上のMacがあれば、OllamaかGGUF版で手元のリポジトリを相手にコード修正を試す
- 日本語の仕様書やコメントを読ませ、言語が混ざらないかを先に確認する
- 社内で使う場合は、モデルカードのライセンス表記(Apache 2.0)を法務と確認する