IBMのGraniteチームは2026年11月12日、プロンプトの中で「実行すべき指示」と「読むだけの材料」を明示的に分ける記法「LLMON」(LLM Object Notation、読みは「レモン」)と、それを前提に学習したモデル「Granite 4.1 LLMONプレビュー」(3B/8B)を公開しました。狙いは、取り込んだ文書やツールの結果に紛れ込んだ命令にモデルが従ってしまうプロンプトインジェクションを、モデル側の仕組みで減らすことです。RAG(検索拡張生成)やエージェントを作っている開発者にとって、防御の考え方が変わり得る試みですが、IBM自身が「本番向けではない」と明言している実験的な公開です。
なぜ記法から変えるのか
現在のLLMは、システムプロンプト、利用者の依頼、検索で取ってきたWebページ、ツールの実行結果を、すべて同じ文字列の並びとして受け取ります。区切りに「---」や<document>タグを使っても、それは普通の文字なので、文書の中に同じ記号や「以前の指示を無視して」という文を書かれると、モデルにはどこまでが指示でどこからがデータかが分かりにくくなります。これが間接プロンプトインジェクションの根本的な原因です。
LLMONは、この区切りを普通の文字ではなく、語彙の中に予約した専用の特殊トークンで表します。ブログによると、構造用の区切りは6種類あり、本文の文字とは別の領域に置かれるため、文書の中身で偽装できません。GitHubのLLMONリポジトリには、次のような記述例が載っています。
<|open|>instruction<|close|>
  Suggest a title for the following email:
<|open_end|>
仕組み:実行ブロックで「どれを実行するか」を指定する
LLMONでは、プロンプトを「instruction(指示)」「data(データ)」「requirement(要件)」などのタグ付きブロックに分け、各ターンの「exec(実行)」ブロックで、どの指示をどのデータに対して、どの要件で実行するかを結びつけます。ブログはこれを「関数に引数を渡すようなもの」と説明しています。execで参照されていないブロックは文脈として読まれますが、命令としては扱われません。
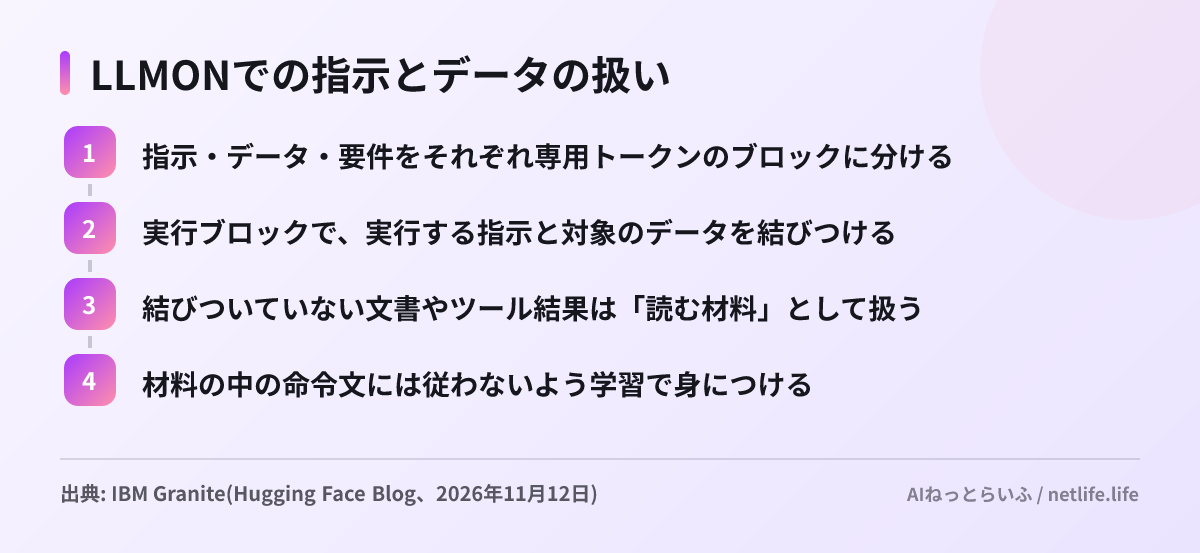
学習では、Granite 4.1のベースモデルから出発し、通常の指示学習データをLLMON形式に書き直したうえで、実行ブロックに結びつかない「おとりの指示」を文脈に混ぜて無視することを覚えさせました。その後、強化学習(GRPO)を5段階、最後に注入攻撃への応答から作った1,000組の選好データでDPOを行っています。重要なのは、「実行ブロック経由の指示だけが正」というルールが、仕組みで強制されるのではなく学習で身につけたものだという点です。
効果と限界
プロンプトインジェクションの評価OPIでは、LLMONモデルはテストした最良のフロンティアモデルより47%多く、最良のオープンモデルより95%多く攻撃を防いだと報告しています。ASBやStruQといった別の評価でも同じ傾向で、一部では攻撃成功率がほぼゼロになったとしています。一般的な性能は通常のGranite 4.1 Instructと同程度だそうです。ただし具体的な数値はブログ内のグラフ画像でしか示されていません。
限界もはっきり書かれています。
- 本番用ではなく、検証・評価向けの実験的プレビュー
- 防御は学習によるもので保証ではない。モデルカードは、機密性の高いシステムに触れるエージェントの唯一の防御にしないよう求めている
- 評価は一度きりの静的な注入が対象で、複数ターンにわたる適応的な攻撃は今後の課題
- LLMON形式の入力が前提で、通常のチャット形式で使うと品質が落ちる
日本の読者にとって
モデルはApache 2.0ライセンスで、Hugging Faceから誰でもダウンロードできます。モデルカードでは日本語を含む12言語に対応するとされており、日本語の社内文書を扱うRAGでも試せます。利用時は普段どおりmessagesのリストを作り、各要素に実行対象かどうか(exec)の印を付けてapply_chat_templateに渡せば、LLMONの記法はテンプレートが組み立てます。
国内でも社内文書やメールをAIエージェントに読ませる導入が進んでいますが、現状の対策は「区切りタグ+システムプロンプトでの注意書き」に頼ることが多いはずです。主要モデルも耐性の数字を競い始めており、Gemini 4 Hydrogenも間接プロンプトインジェクションへの耐性向上をうたっています。LLMONは、それをプロンプトの書き方の標準として切り出そうとする点が新しいと言えます。今後、他社のモデルが同様の考え方を採り入れるかが注目点です。
次にやることは3つです。
- 自社のRAGやエージェントで、取り込みデータに命令文を混ぜたテストケースを用意し、現行モデルとLLMONプレビューで結果を比べる
- 外部データと指示を同じ文字列に連結している箇所を洗い出し、どこで区切っているかを確認する
- モデル側の対策に頼り切らず、ツールの権限制限や人による承認など、別層の防御を維持する