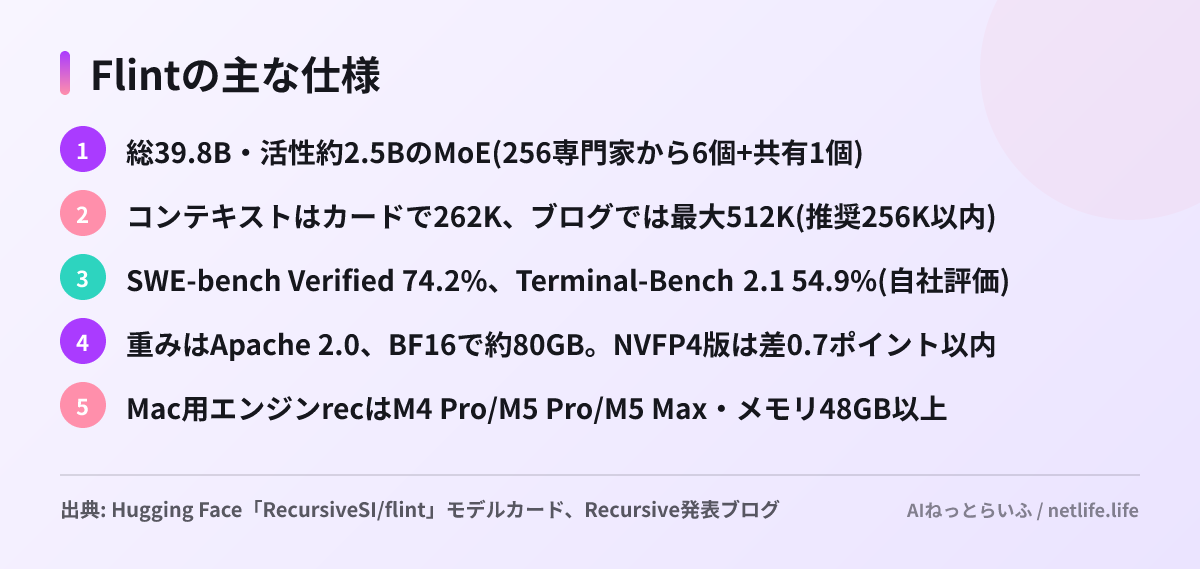
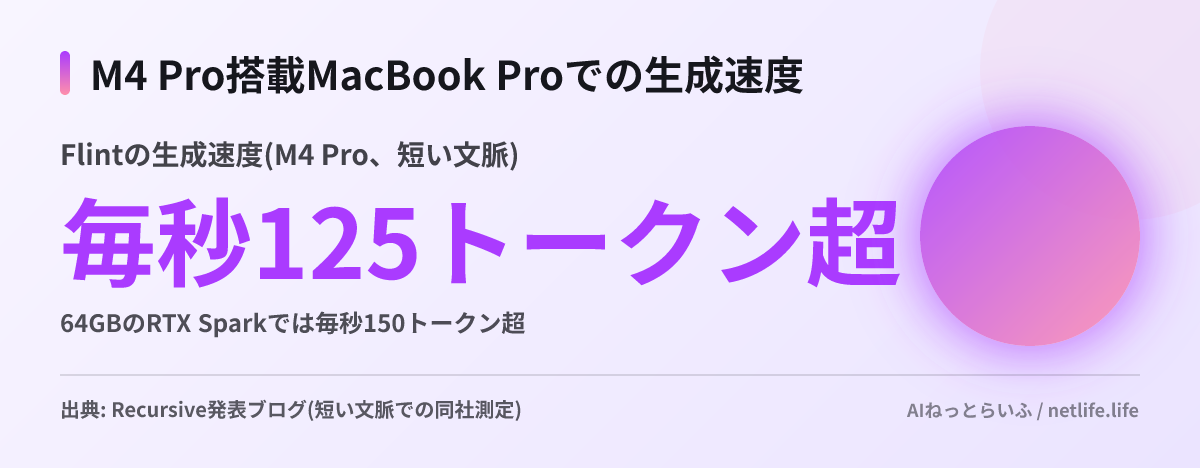
AI研究企業のRecursiveは今週、初のモデル「Flint」の重みをHugging Faceで公開しました。総パラメータ39.8B(約400億)のうち、1トークンあたりに使うのは約2.5Bだけという、コーディングエージェント向けのMoE(Mixture of Experts、入力ごとに一部の専門家ネットワークだけを動かす構成)モデルです。ライセンスはApache 2.0で商用利用に制限がなく、同社はM4 Pro搭載のMacBook Proで毎秒125トークンを超えると説明しています。社外にコードを出せない環境で、手元のマシンにコーディングエージェントを置きたい開発者に関係する発表です。
Flintの中身
モデルカードによると、Flintは49層のTransformerで、最初の2層以外はMoE層です。256個の専門家から1トークンごとに6個を選び、常に動く共有の専門家を1個持ちます。注意機構は35層が直近513トークンだけを見るスライディングウィンドウ、14層が全体を見る方式で、長い文脈でも計算量を抑える設計です。コンテキスト長はモデルカードでは262,144トークンですが、発表ブログでは最大512Kで、256K以内の利用を推奨するとしており、資料間で表記が揃っていません。
用途はコードベースの調査、バグ修正、機能実装、テスト作成などのエージェント作業です。BF16の重みは15ファイル・合計約80GBで、NVIDIA向けとApple Silicon向けの量子化版も別に用意されています。発表ブログでは、4ビットのNVFP4版の評価結果は16ビット版と比べて0.7ポイント以内の差に収まったとしています。
なぜ注目されるのか
Recursiveは、Flintの開発の大部分を「Eureka Machine」という自動研究の仕組みで進めたと説明しています。アイデアの提案、実装、検証、次の方針の決定を並行して繰り返すもので、総35B・活性3Bの構成から始めた専門家の数の探索、出力層の4ビット量子化、M4/M5チップ向けの専用カーネル作成に使ったとしています。人とエージェントの小さなチームで4カ月足らずで作ったという点が、同社の売りです。
性能面では、活性パラメータが少ないぶん速く、同社は同じ規模の密なモデル(全パラメータを毎回使う構成)の25〜40B級と同等の性能を5倍以上の速さで出せると主張しています。手元のマシンでエージェントを動かすと、1つの作業で何十回もモデルを呼ぶため、1回あたりの速度が使い勝手を大きく左右します。
ベンチマークの読み方
スコアはいずれもRecursive自身の評価です。モデルカードの数字はSWE-bench Pro v2が89.7%、SWE-bench Verifiedが74.2%、Terminal-Bench 2.1が54.9%です。SWE-bench Pro v2はVerifiedより高い数字になっており、従来のSWE-bench Proとは別の版なので、他社が公表しているSWE-bench Proのスコアとは並べられません。比較対象のモデル名と数字はブログ内の画像にしかなく、本文では確認できませんでした。
同社は総50B未満のMoEで首位だとしていますが、当サイトで紹介したK2 Horizonの36B-A4BはTerminal-Bench 2.1で58.6%を公表しています。Flintはウェブ検索で答えを見つけた解答を失敗として数えるなど、評価条件が異なるため単純な比較はできません。自社のリポジトリで試して判断するのが確実です。
日本の開発者にとって
手元で動かす方法は複数あります。Mac向けにはRecursiveの推論エンジンrecがあり、M4 Pro・M5 Pro・M5 Maxで、統合メモリ48GB以上と空き容量約30GBが条件です。OpenAI互換のAPIを出し、rec launch opencodeでOpenCodeと組み合わせられます。同社はllama.cppより1.4〜2.6倍速いとしています。llama.cpp、Ollama、LM Studio、vLLM、SGLangにも対応します。
注意点もあります。モデルカードにもブログにも日本語への対応は書かれていないため、日本語のコメントや仕様書を読ませる用途は事前の確認が必要です。同社自身も、大きな商用のコーディングモデルより細かい指示が必要で、複雑な作業は小さく分けて渡すよう勧めています。同じく手元向けのLFM2.5-24B-A2Bは年商1,000万ドル超の商用利用に別契約が要りますが、FlintはApache 2.0なので社内導入の手続きは軽く済みます。
試すなら次の順番がよさそうです。
- 48GB以上のApple Silicon Macがあれば、recかOllamaの量子化版で社内の小さなリポジトリのバグ修正を任せてみる
- 普段使っている商用モデルと同じ課題を解かせ、成功率と所要時間を比べる
- 日本語の課題文とコメントで精度が落ちないかを、英語の課題文と並べて確認する