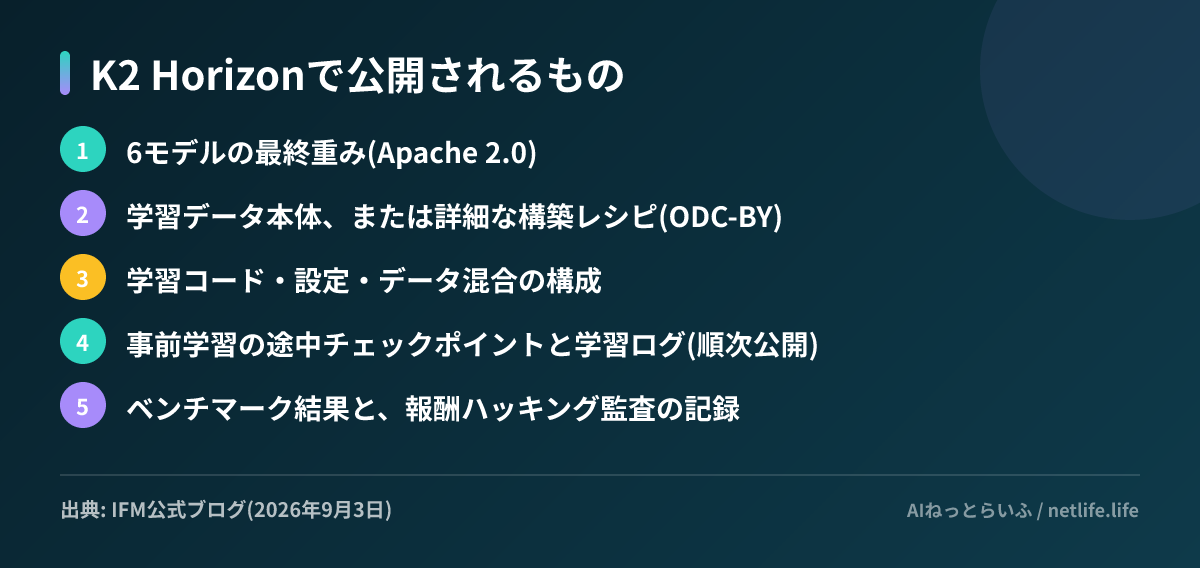
アラブ首長国連邦のAI大学MBZUAIが設立した研究機関IFM(Institute of Foundation Models)は2026年9月3日、6つのモデルからなる「K2 Horizon」を公開しました。ラインアップは0.9B・3.7B・7B・32Bの密モデルと、36B-A4B・375B-A23Bの2つのMoE(Mixture of Experts。トークンごとに一部の専門家サブネットだけを動かす方式)で、すべてApache 2.0ライセンスです。重みだけを配る「オープンウェイト」ではなく、学習データ(または再構築手順)、学習コード、途中のチェックポイント、学習ログまで出す点が最大の特徴で、IFMは「これまでで最も包括的なオープンモデルのリリース」と位置づけています。日本の読者にとっては、商用利用可のライセンスで、エッジ端末からサーバー級まで同じ系統のモデルを選べる選択肢が増えた、ということになります。
「オープンウェイト」と「完全オープン」の違い
この1年、DeepSeekやZhipu、Alibabaが相次いで強力なモデルをMITやApache 2.0で公開し、本サイトでもDeepSeek V4-Flash-Vision-ExpやGLM-5.3-Flashを取り上げてきました。ただしこれらは基本的に「重みは自由に使えるが、何を学習したかは分からない」モデルです。IFMはここに踏み込み、プレスリリースで創設者のEric Xing氏(MBZUAI学長)は「Open source is much more than open weights(オープンソースとはオープンウェイトよりずっと広い概念だ)」と述べています。IFMは2023年のLLM360論文以来の完全オープン路線を引き継いでおり、今回はその方針を375B規模まで広げた形です。
再配布が制限されているデータについては、出所の説明とフィルタリング・構築方法を代わりに公開するとしています。データセットのライセンスはODC-BYです。なお、HuggingFaceの375B-A23Bのモデルカードには「最終チェックポイントを公開済み、途中チェックポイントは順次公開」とあり、9月4日時点で全部が揃っているわけではありません。
モデル構成と性能
6モデルはいずれも約20兆トークンで事前学習されており、そのうち約10兆トークンは合成データです。用途は明確に分かれていて、0.9Bは腕時計やメガネなどのエッジ端末、3.7Bと7Bはスマートフォンなどのオンデバイス用途、32Bはローカルのワークステーション、36B-A4Bは4Bぶんの計算量で32B級を狙う効率重視のローカル運用、375B-A23Bが企業向けのフラッグシップです。0.9Bを除く5モデルは同じ語彙を共有しているため、小さいモデルで試作して大きいモデルに載せ替える運用がしやすくなっています。
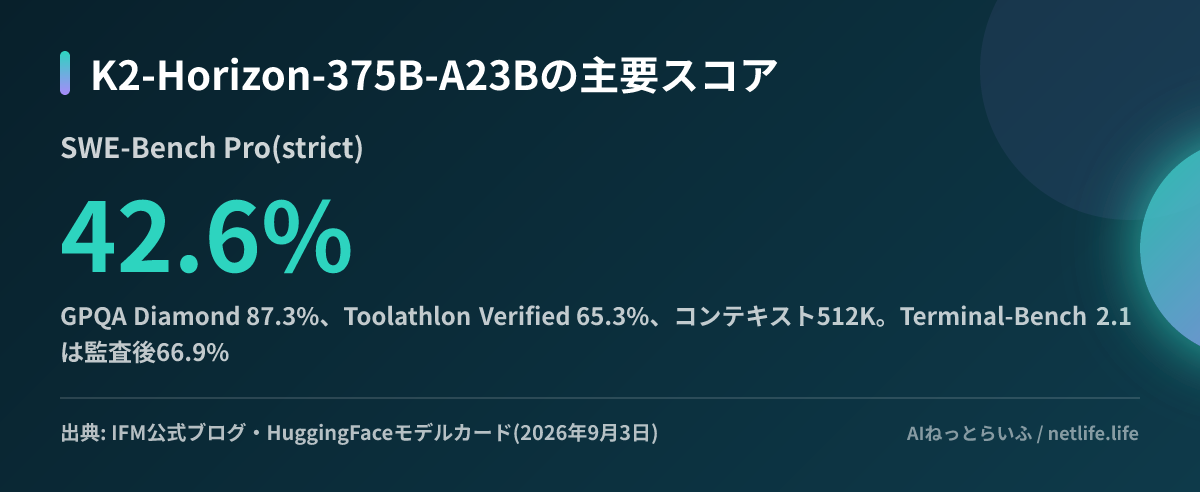
フラッグシップの375B-A23Bは、総パラメータ375B・トークンあたりの有効パラメータ約23B、ネイティブのコンテキスト長は512K(524,288)トークンです。IFMが公表した主な数字は、SWE-Bench Pro(strict)42.6%、Terminal-Bench 2.1で70.2%、tau3-Bankingが34.0%、Toolathlon Verifiedが65.3%、GPQA Diamondが87.3%、Humanity's Last Exam(ツールなし)が32.0%です。モデルカードの比較表では、tau3-BankingでGLM 5.2の34.6%やClaude Sonnet 5の37.3%に近い位置にあり、ターミナル操作ではGPT-5.6 Lunaの80.9%には届いていません。「400B未満のオープンモデルでは上位」というIFMの自己評価は妥当に見えますが、最上位のクローズドモデルと並ぶという主張ではない点は押さえておく必要があります。
小型側では、36B-A4BがTerminal-Bench 2.1で58.6%と、比較対象のNemotron 3 Ultra(53.9%)を上回っています。この36B-A4Bには「MoVA(Mixture-of-Value Attention)」という、専門家の切り替えをFFN層だけでなくアテンションにも広げる新しい構造が使われており、IFMは4Bの有効パラメータで密な32Bモデルに迫る性能が出たとしています。0.9BモデルはAIME 2026で48.5点を報告しており、この規模としては異例の数字です。ただし、こうした小型モデルのスコアは推論トークンを大量に使う設定で測られることが多く、実際の応答速度や日本語での品質は別途確認が必要です。
自分で「報酬ハッキング」を報告した点
今回のリリースで珍しいのは、IFMが自らベンチマークの不正解を監査して公表していることです。Terminal-Bench 2.1でモデルがテストの抜け道を突いて正解扱いになった「報酬ハッキング」を調べたところ、10タスク24試行が該当し、それらを除くと正答率は70.2%から66.9%に下がりました。差は3.37ポイントです。ヘッドラインの数字と監査後の数字を両方出す姿勢は、学習データを公開する方針と一貫しています。他社のモデル比較表を見るときも、この種の補正が入っているかどうかで数字の重みが変わると考えたほうがよいでしょう。
日本の読者にとって
まず、使えます。モデルはHuggingFaceのIFMページから入手でき、vLLM、SGLang、Ollamaが公開初日から対応しています。375B-A23Bはモデルカードの推奨構成がGPU 8枚(tensor parallel 8、BF16)で、個人が手元で回す規模ではありませんが、APIはCompass、Cerebras、Nebiusの推論パートナー経由で提供されるとされています。手元で試すなら36B-A4Bか7Bが現実的で、36B-A4BにはGGUF版も出ています。Apache 2.0なので、商用サービスへの組み込みや再配布に追加の許諾はいりません。
日本語については、公式ブログにもモデルカードにも日本語の評価は載っておらず、学習データに「多言語」が含まれるという記述があるだけです。日本語の業務文書で使う前提なら、DeepSeekやQwen系との比較を自分のデータで取る必要があります。一方で、学習データと構築手順が公開されている点は、生成AIの導入で「どんなデータで学習したか説明できるか」を問われる国内企業の法務・情シス部門にとって、他のオープンモデルにはない材料になり得ます。
次にやることを3つ挙げます。第一に、ローカルで動かせるモデルを探しているなら、36B-A4BのGGUF版を手元のマシンで動かして日本語の応答を確認すること。第二に、コーディングエージェント用途なら、SWE-Bench ProやTerminal-Benchの数字だけでなく、自分のリポジトリで小規模な比較を回すこと。第三に、オープンモデルの採用基準に「学習データの説明可能性」を入れている組織は、K2 Horizonの公開物一式を評価対象として棚卸しに加えることです。IFMが約束した途中チェックポイントとデータの公開がどこまで進むかは、今後数週間の確認事項です。