Googleは2026年10月20日(米国時間)、PyTorchのプログラムを自社のAIチップTPU(Tensor Processing Unit)で動かすための基盤「TorchTPU」をオープンソースとして公開しました。ライセンスはApache 2.0で、MetaのPyTorchチームと共同で開発したものです。前日にはAWSも自社チップTrainium向けのTorchNeuronを公開しており、PyTorchで書いたモデルをNVIDIAのGPU以外で動かす選択肢が、ここ2日で大きく広がりました。クラウドのGPU不足や費用に悩んでいる開発チームにとって、計算資源の選び方を見直すきっかけになります。
なぜ今、PyTorchのTPU対応なのか
AI開発で使われるフレームワークの主流はPyTorchですが、これまでTPUで性能を出すにはGoogle製のJAXを使うか、PyTorch/XLAという橋渡しの仕組みを経由する必要がありました。後者は書き方の制約や性能調整の手間があり、「GPUで動いているコードをそのまま持っていく」ことは簡単ではありませんでした。NVIDIAが強い理由の1つは、GPU向けのソフトウェア資産(CUDA)にこうした乗り換えの壁があることだと言われています。
Googleはブログで「TorchTPUによって、TPUはGPUやCPUと並ぶPyTorchのネイティブな選択肢になる」と述べています。既存のPyTorchの書き方をほぼ変えずにTPUへ載せられることが売りで、デバッグしやすいeagerモード(1行ずつ実行するモード)で動かしたうえで、本番ではtorch.compileで最適化する、というGPUと同じ流れを取れるとしています。
何が公開されたか
公開されたのはTorchTPU本体に加え、周辺ツールとの連携一式です。
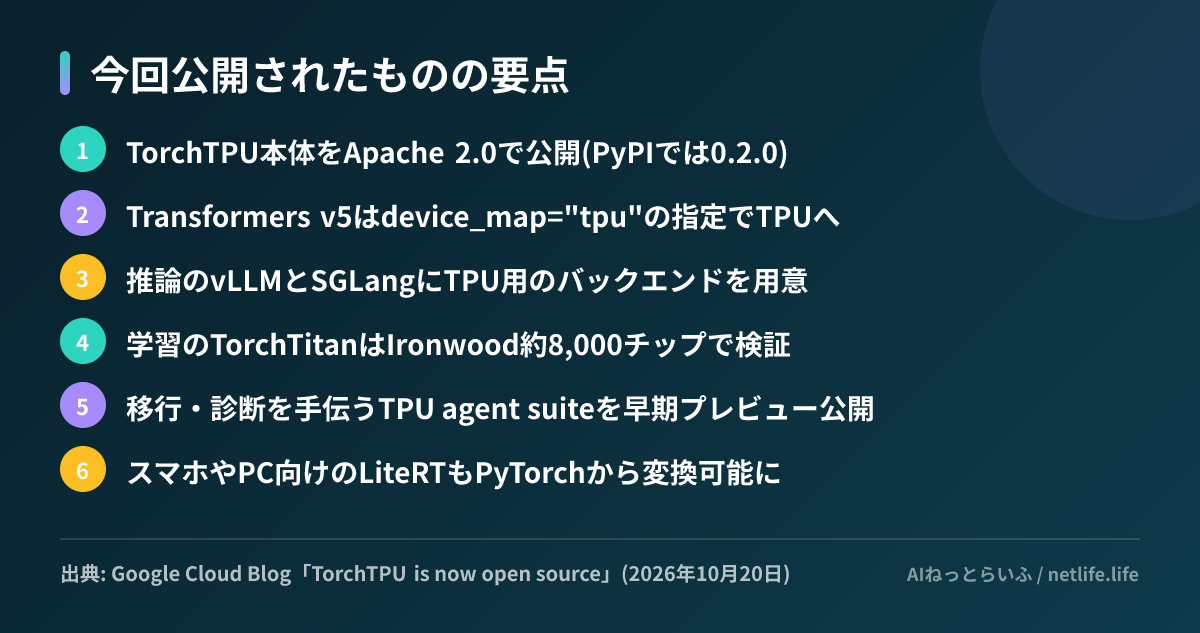
推論では、OSSの推論サーバーとして広く使われるvLLMとSGLangに、TPU向けのバックエンドが用意されました。連続バッチ処理や量子化、複数チップでの並列化に対応し、既存のAPIサーバーの仕組みはそのまま使えるとしています。導入事例として、Zenteiqという企業が推論のスループットを4倍超に高め、TPU v6e 1,000基あたりの1日の生成トークン数が14.7億から59.7億になったという数字が紹介されています。
学習では、PyTorch公式の学習フレームワークTorchTitanで、Llama 3やQwen 3、FLUX.1などのレシピを用意しました。最新世代のIronwood(TPU v7x)で、Qwen 3 8Bの学習時にモデルFLOPs利用率(MFU、チップの理論性能をどれだけ使えているかの指標)最大52%を出し、最大8,192チップまでほぼ比例して性能が伸びたとしています。
もう1つ目を引くのが、TPU agent suiteです。コーディングエージェントにプラグインとして組み込み、TPUへの移行作業、エラーの診断、推論性能の調整などを自動化することを狙ったもので、まだ早期プレビューの段階です。
AWSのTorchNeuronと何が同じか
前日にAWSが公開したTorchNeuronも、狙いはほぼ同じです。
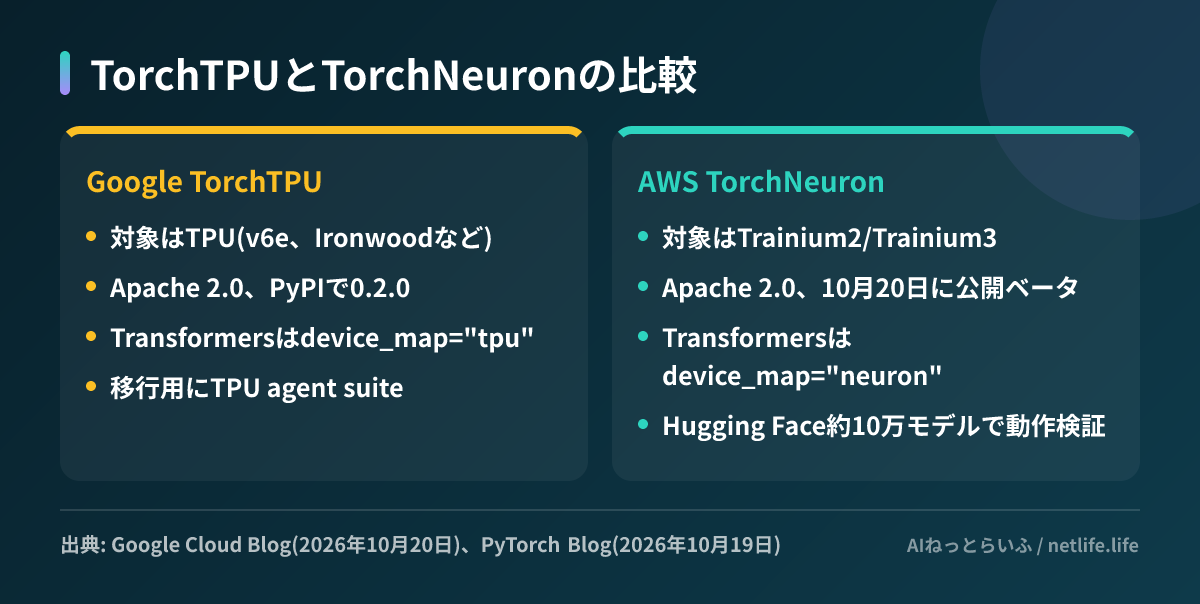
どちらもPyTorch Conference 2026に合わせて発表され、「設定を変えるだけで既存のPyTorchコードを自社チップで動かせる」ことを前面に出しています。AWSはHugging Faceの約10万モデルを対象に読み込みや学習が動くかを確かめた結果を公表している一方で、まだ専用の処理が用意されていない演算が約2万2,000件あることも明かしています。Googleのブログには、こうした未対応の範囲や制約は書かれていません。リポジトリのREADMEでも依存関係の欄は「TBD(未定)」のままで、成熟度はこれから見極める段階と考えられます。
日本の読者にとっての意味
国内でもクラウドのGPUは確保が難しく、高価な状態が続いています。PyTorchのコードをほぼそのままTPUやTrainiumに載せられるなら、「GPUの空きが出るまで待つ」以外の選択肢を検討しやすくなります。特に、Hugging Faceのモデルを使った推論や追加学習は、今回の対応範囲に入っており、最初に試しやすい領域です。
チップをクラウド事業者が自前で作り、ソフトの壁を崩しにいく流れは、MicrosoftのMaia 300の発表とも共通しています。ただし、TPUやTrainiumはそれぞれGoogle CloudとAWSでしか使えず、利用できるリージョンやチップの世代もクラウドごとに異なります。東京・大阪リージョンでどの世代を使えるか、データを国内に置く必要があるかは、事前に確認が必要です。また、GPUからの乗り換えでは、独自に書いたCUDAカーネルや、まだ対応していない演算が残ることも想定しておくべきでしょう。
次にやること
- Hugging Faceのモデルで推論をしているなら、TPU v6eの環境でdevice_map="tpu"を指定し、今のGPU環境と速度・費用を比べてみる
- vLLMやSGLangを本番で使っている場合は、TPU向けバックエンドのリポジトリで対応機能と制約を確認する
- AWSを主に使っているチームは、TorchNeuronの公開ベータで同じモデルを試し、2社のチップを費用対効果で比べる