Anthropicは10月22日、Claudeを使って、Googleのファジング基盤OSS-Fuzzに登録された123のオープンソースライブラリについて、239個のファズテストの入口が「64MB未満のどんな入力でもクラッシュしない」ことを形式的に証明したと公表しました。証明の対象はソースコードではなく、コンパイル後のRISC-V機械語です。証明しようとする過程で数百件のバグが見つかっており、C/C++のライブラリを使う開発者や、OSSのメンテナーに関係する発表です。
何をしたのか
形式検証とは、プログラムが仕様を満たすことを数学的な証明で示し、その証明を機械で検査する手法です。テストやファジング(ランダムな入力を大量に与えてクラッシュを探す手法)は「見つかったバグがある」ことは示せても、「バグがない」ことは示せません。形式検証はその後者を狙います。
今回の手順は単純な構成です。まず、OSS-Fuzzに既にあるファズテストをRISC-V向けにコンパイルし、「このファズテストは64MB未満のどの入力でもクラッシュしない(メモリ安全性の検査器AddressSanitizerも反応しない)」を仕様とします。次にClaudeがその機械語に対する証明を書き、証明支援系Rocq(旧Coq)の検査器が正しさを確かめます。RISC-V命令とLinuxプロセスの意味論(どの命令が何をするかの形式的な定義)は、共同研究先のTheoremが用意しました。
規模は次のとおりです。
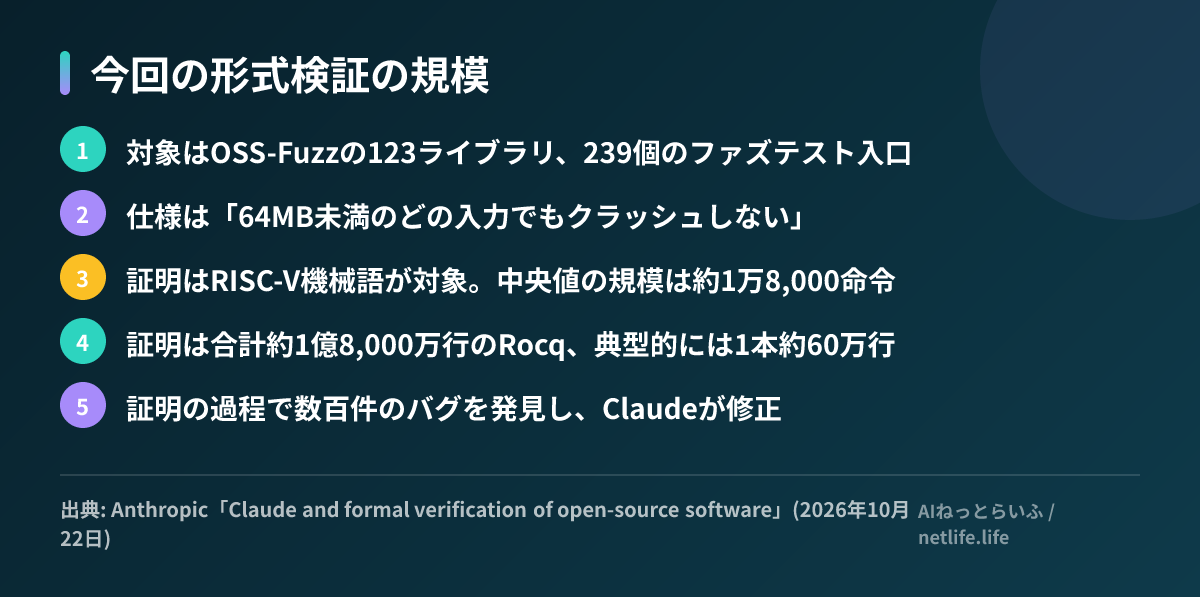
証明できないコードはそもそもクラッシュし得るので、証明の試み自体がバグ探しになります。Anthropicによると、この過程で数百件のバグが見つかり、libexpatの既知の脆弱性CVE-2026-56132(深い入れ子の入力が必要なもの)も再発見しました。別の取り組みでは、広く使われるPDFリーダーで、通常1年間に報告されるのと同じ数のセキュリティバグを1週間で見つけたとしています。
なぜ機械語レベルの証明が意味を持つのか
背景には、AIによる脆弱性発見が修正の速度を上回りつつあるという問題があります。当サイトでも、AIで見つかったPHPの重大な脆弱性PHP2Shellや、Anthropicのメンテナー向け無償スキャンOSS Scannerを取り上げました。見つけたバグを一つずつ直す方式には限界があり、「この範囲の入力ではクラッシュしない」と保証できれば、攻撃者がAIで探しても見つからない領域を作れます。
形式検証そのものは昔からある技術ですが、人手のコストが障壁でした。Anthropicは、マイクロカーネルseL4の実装に約2人年、検証に約20人年かかった例を挙げています。今回は数週間で123ライブラリを扱っており、証明を書く作業の大半をAIに任せられるようになったことが変化の中心です。
機械語を対象にした点も重要です。ソースコードで証明しても、コンパイラの最適化や未定義動作の解釈で実際の動作がずれる余地が残ります。コンパイル後のバイナリを直接証明すれば、その差は問題になりません。
コストとハマりどころ
一方で、証明は数億トークン規模になることがあり、費用は公表されていません。効率化の材料として、小さな検証課題36問のうち半分をOpus 5.5がOpus 5より約40%少ないトークンで証明したこと、共有の作業場で複数のエージェントが協力すると単独より17%少ないトークンで済んだことが示されています。
「報酬ハッキング」への対策も書かれています。Claudeはバグを直してから証明し直すため、コードを「何もしない」ように書き換えれば簡単に証明が通ってしまいます。Anthropicは修正にペナルティを課し、修正内容をすべて記録・監査したとしています。AIに検証させるときに検証対象そのものを書き換えさせる危うさは、自分のプロジェクトでAIにテストを通させる場合にも当てはまる教訓です。
「形式検証済み」でも残る穴
Anthropic自身が「形式検証済みはバグがないという意味ではない」と明記しています。主な前提は次のとおりです。
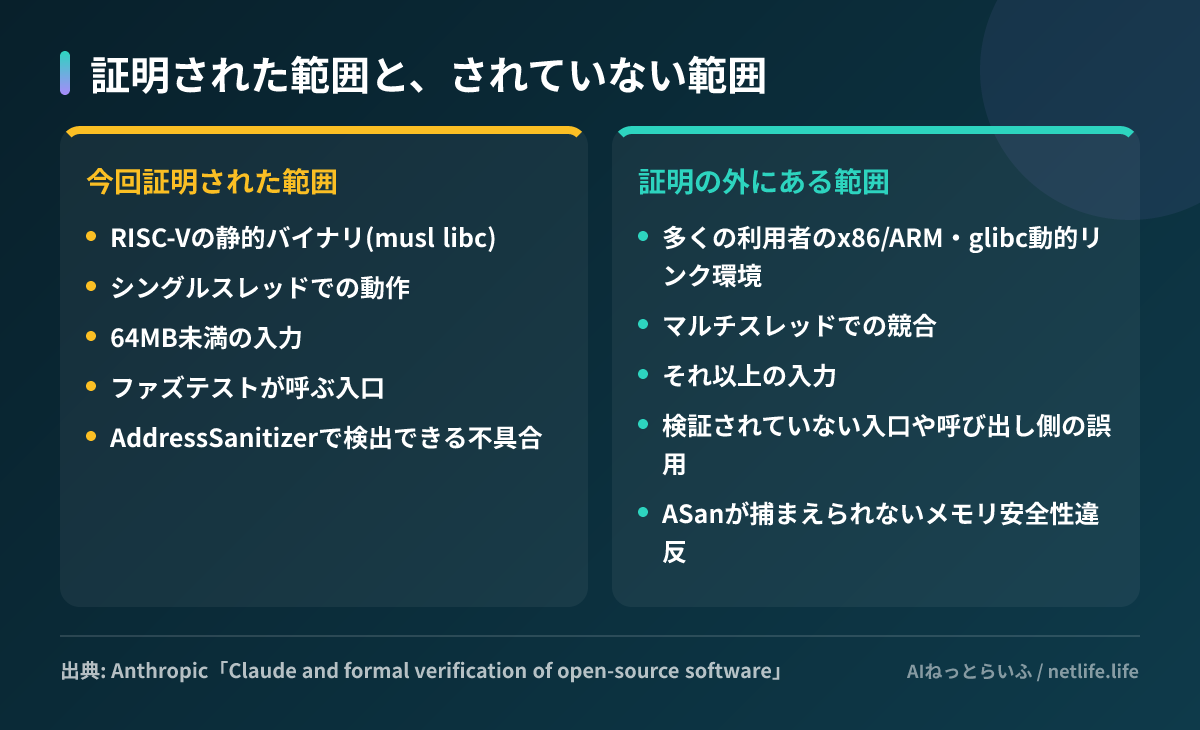
信頼の基盤であるRocq、RISC-VとLinuxの意味論そのものに誤りがあれば、証明の意味も揺らぎます。つまり今回の成果は「手元のビルドが安全になった」ことを直接は意味しません。ただし、証明の過程で見つかって修正されたバグは、上流に取り込まれれば利用者全員の環境に効きます。
日本の開発者・メンテナーにとって
利用者側としては、zlibやlibexpatのように日本のプロダクトにも組み込まれているライブラリで、AIが大量のバグを掘り出す流れが続いていると考えられます。依存ライブラリの更新を後回しにする運用は、今後さらにリスクが高まる可能性があります。
メンテナー側には具体的な窓口があります。TheoremはOSS Verifyとして、同じパイプラインを無償で提供しています。条件は、広く使われていて活発に保守されていること、OSI承認ライセンスであること、パーサーや暗号のようにセキュリティ上の影響が大きいことなどで、登録できるのは中核メンテナーに限られます。GitHubのリポジトリにproject.yamlとDockerfile、build.shを置くプルリクエストを送る形式で、静的なriscv64バイナリをビルドできる必要があります。発見はAIが生成したもので、人の確認前に届くことがある点に注意が必要です。
公開済みの証明の一部と意味論はoss-verify-proofsとrocq-linux-process-semanticsで読めます。未修正のバグを示し得る証明は公開されていません。
次にやることとしては、次の3つが考えられます。
- 自社製品が依存するC/C++ライブラリを洗い出し、上流の修正版に追従できる更新手順を整える
- OSSを保守しているなら、OSS Verifyの条件に当てはまるか確認し、ファズテストをRISC-V静的ビルドで動かせるか試す
- AIにコード修正とテストの両方を任せている場合、テストやコードを「通るように書き換えた」差分がないかレビュー項目に入れる