
Microsoftは2026年10月12日(米国時間)、自社設計のAIアクセラレーター(AI処理専用チップ)の第3世代「Maia 300」を発表しました。2027年から数ギガワット規模で配備し、Maiaを「Microsoftの製品とサービスにおける主要なAI推論システム」にするとしています。Microsoft 365 Copilot、GitHub Copilot、Microsoft Foundry(旧Azure AI Foundry)を使う企業にとっては、サービスの裏で動くハードウェアがNVIDIA製GPU中心から自社チップ中心に移っていく、という発表です。
発表は、Azureを率いるScott Guthrie氏の公式ブログと、設計担当者による技術解説記事の2本で行われました。
なぜ今、自社チップなのか
AIの計算は、モデルを作る「学習」と、できたモデルで回答を返す「推論」に分かれます。CopilotのようにAIを日常業務へ組み込むサービスが広がるほど、費用の大半は推論が占めるようになります。Microsoftは技術解説で、目標を「電力1ワットあたり、1ドルあたりに得られる有用なトークンを最大化すること」と書いています。
背景には電力の制約があります。データセンターの新設は電力の確保が律速になっており、同じ電力でどれだけ多く回答を返せるかが、そのままサービスの原価と提供量を決めます。Microsoftが今回、性能を「メガワットあたりのトークン数」で語っているのはそのためです。
前世代のMaia 200は2026年1月に登場し、現在は米国・欧州・オーストラリアで稼働しています。Microsoftによると、TeamsやCopilotなどに組み込まれたAI機能の処理で、主要なGPU基盤より最大1.7倍多くのトークンを1ワットあたりに出せているといいます。OpenAIのモデル、Microsoft自身のMAIモデル、オープンソースのモデルが動いており、年末までにGitHub CopilotとFoundryも載せる予定です。Maia 300はこの路線を一段大きくするものです。
Maia 300で何が変わるのか
Maia 300は推論専用に設計されています。演算部分のダイ(チップ本体)をTSMCの2ナノ世代プロセスN2Pで作り、メモリと入出力の機能は別のダイに分けました。この分割によって演算性能を36%、スケールアップ帯域(チップ同士を直結する通信の帯域)を14%上乗せできたと説明しています。
メモリは最新の広帯域メモリHBM4を8基積み、容量288GB、帯域は毎秒18TBです。大規模モデルの推論はメモリから重みを読み出す速さが性能を左右しやすいため、ここを最も強化しています。モデルの数値を4ビット程度に縮めて扱うMXFP4形式の強化や、3ビット未満で重みを保存する形式への対応も加わりました。
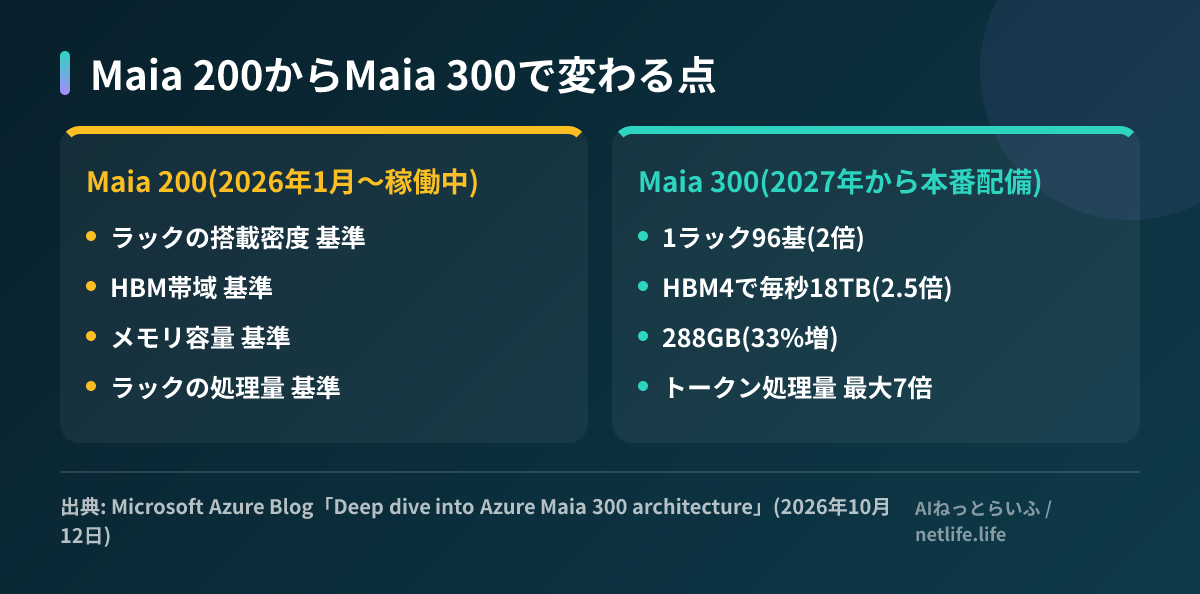
1つのラックには96基を載せ、消費電力は167キロワットです。熱の8割超を液体で冷やします。ラック同士は光ファイバーのスイッチでつなぎ、最大128ラック、1万2,288基を1つのまとまり(スーパーポッド)として扱えます。回答の前半処理(プロンプトの読み込み)と後半処理(1語ずつの生成)を別々の機器に割り振る「分離型推論」にも対応しました。
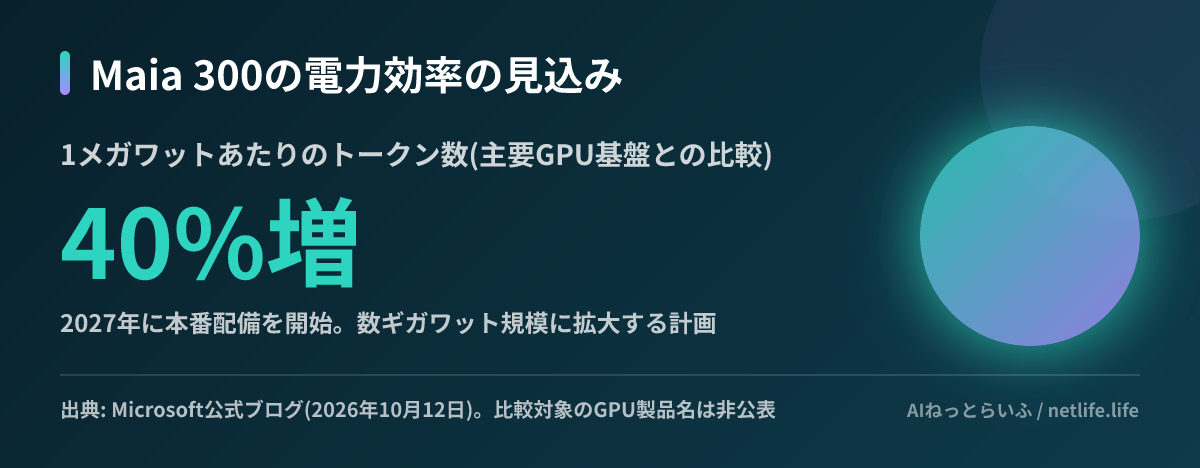
Microsoftは、96基を搭載した構成のラック全体でMaia 200の最大7倍のトークンを処理でき、電力あたりの性能は2.5倍超になるとしています。さらに、主要なGPUベースのシステムと比べて、1メガワットあたり40%多くのトークンを出せる見込みだと述べています。
数字を読むときの注意
40%と7倍はいずれもMicrosoft自身の見込みで、比較したGPU製品名や測定したモデル、条件は公表されていません。本番配備は2027年からで、どの地域から入るかもまだ示されていません。詳細は11月17〜20日のMicrosoft Ignite 2026で説明するとしています。
また、NVIDIAとの関係が切れるわけではありません。モデルの学習や外部の顧客に貸し出すGPUインスタンスは引き続きNVIDIAやAMDの製品が担うと考えられ、Maiaはまず自社サービスの推論を受け持つ位置づけです。
日本の読者にとっての意味
まず押さえておきたいのは、Maiaは今のところ利用者が直接借りられるチップではないことです。GoogleのTPUやAWSのTrainiumはクラウドの計算資源として借りられますが、MicrosoftはMaiaの仮想マシンを提供すると発表していません。影響は、Copilot、GitHub Copilot、Foundryといったサービスを通じて間接的に届きます。
そのうえで、影響は2つ考えられます。1つは費用です。MicrosoftはCopilotのエージェント機能を1クレジット0.01ドルの従量課金に切り替えたばかりで、推論の原価が下がれば、料金や利用上限の見直しにつながる可能性があります。ただし、Microsoftは値下げについては何も約束していません。もう1つは供給量です。混雑時の速度低下やレート制限が緩和されることも期待できますが、日本のリージョンにいつ配備されるかは未定です。
Foundryで使うモデルが今後Maia上で動く場合、同じモデル名でも応答速度などがGPU上と変わる可能性はあります。データの所在地(データレジデンシー)を契約で指定している企業は、処理場所の条件がこれまでどおり守られるかを、Igniteでの説明やMicrosoftの資料で確認しておくと安心です。
次にできることは次の3つです。
- Microsoft 365 CopilotやGitHub Copilotを契約している場合、来年度の予算は現行の単価で見積もり、Ignite(11月17〜20日)での料金や提供量の発表を確認してから見直す
- Foundryで本番運用しているモデルは、応答速度と出力の品質を定期的に記録し、裏側の切り替えによる変化に気づけるようにしておく
- データの処理場所に要件がある企業は、Maiaが日本や対象リージョンに入る時期と、処理地域の扱いをMicrosoftの担当者に問い合わせておく


