Metaは2026年10月12日(米国時間)、新しい最上位モデル「Muse Wonder」と「Muse Wonder Full」を公開しました。Muse WonderはMeta Model APIとコーディングエージェントのMuse Codeで当日から使え、API料金は100万トークンあたり入力4ドル・出力20ドルです。上位のMuse Wonder FullはAPIでは提供されず、Muse Codeの有料プラン(月50ドルと月200ドル)の契約者だけが使えます。「安くて速い挑戦者」だったMetaが、価格でも提供形態でもOpenAI・Anthropic・Googleと同じ土俵に移った発表です。
「安さ」から「上位モデル」への転換
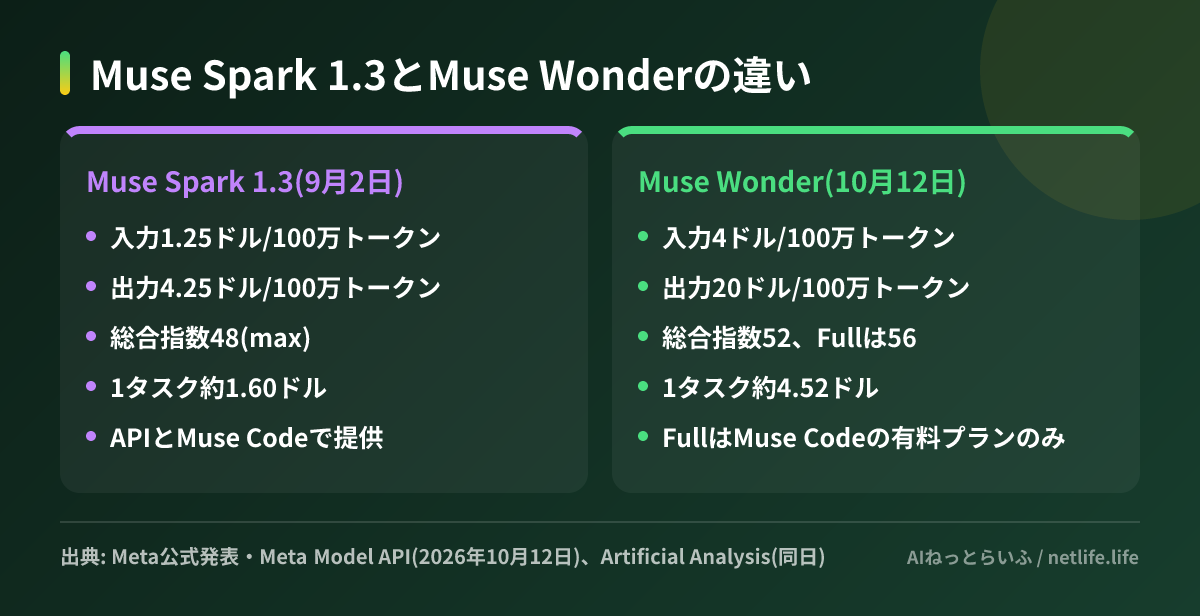
Metaのクローズドモデル系列Museは、9月のMuse Spark 1.3まで、上位モデルに近い性能を数分の1の価格で出すことを売りにしてきました。Spark 1.3の料金は入力1.25ドル・出力4.25ドルで、今回のWonderは入力で3.2倍、出力で約4.7倍です。Wonderの入力4ドル・出力20ドルは、Googleが12月から適用するGemini 4 Argonの通常料金と同額になります。
Metaは発表文で、Wonderを法律・金融・医療のような専門分野と、保険の請求手続きや賃貸契約書の読み込み、動くアプリの作成といった「個人と仕事のエージェント作業」向けのモデルと位置づけています。開発チームの研究ブログによると、学習には同社のギガワット級データセンター「Prometheus」を使い、Spark系で確立した事前学習と強化学習の手法を大きなモデルに広げました。米国でiOS・Android・Mac向けに展開している個人向けエージェント「Muse」にも、近くWonderを使う予定で、まずは有料会員から順に切り替えるとしています。時期は示されていません。
性能はどこまで来たか
Meta自身の発表文には競合との比較表がないため、ここでは独立評価機関Artificial Analysisの測定結果を見ます。同社の総合指数「Intelligence Index v4.3」(推論強度max)は、Muse Wonder Fullが56、Muse Wonderが52で、Spark 1.3の48から上がりました。Fullは10種類の評価のうち6種類で3位以内に入り、物理の研究課題CritPtとPDF文書の処理GDP.pdfではいずれも33%で首位です。実務タスクの評価GDPval-AAは1857で、Claude Opus 5.5の1866、Claude Sonnet 5.5の1838と誤差の範囲内に並んでいます。
コーディングエージェントとしての評価も高く、Muse Code上のWonder Fullは「Coding Agents Index」で68と、Claude CodeでSonnet 5.5を使った場合と同点でした。
弱点は知識と費用
一方で、事実知識と幻覚(もっともらしい誤答)を測るAA-Omniscienceでは、Fullが30、Wonderが25にとどまりました。Claude Opus 5.5の46、GPT-6 Astraの43、Gemini 4 Argonの42とは差が大きく、調べ物や事実確認の比重が高い用途では不利と考えられます。ただし幻覚率そのものは、Fullで33%から23%に下がっています。
費用面では、Intelligence Indexの1タスクあたりの費用がWonderで約4.52ドルと、Spark 1.3の約2.8倍でした。このうち76%が入力トークン代で、入力単価の高さと入力トークンの多さが効いています。同じ測定でGPT-6 Astra(max)は約3.26ドル、Gemini 4 Argon(high)は約1.99ドルです。トークン単価の安いモデルを探している人にとって、Wonderは選択肢になりにくい結果です。
日本の読者にとって
発表文とAPIのモデルページには提供地域の記載がなく、Spark 1.3と同じくMeta Model APIとMuse Codeは日本からも契約・利用できると見られます。ただし消費者向けアプリのMuseは9月の提供開始時点で米国のみで、Wonder搭載版が日本で使えるかは未定です。1ドル=150円で換算すると、Wonderの料金は入力100万トークンで約600円、出力で約3,000円になります。
日本語性能について、Metaのモデルカードは「多言語データで学習した」と書くだけで、日本語の評価結果は示していません。日本語の契約書や社内文書を扱うなら、自社データでの検証が欠かせません。
開発チームの視点では、APIはOpenAI SDK互換で、既存のコードからモデルIDを muse-wonder-1.0 に替えるだけで試せる作りです。コンテキストは両モデルとも100万トークンで、テキスト・画像・動画・音声を入力でき、出力はテキストのみです。最上位のFullを試すには、Muse Codeの「Power Usage」(月50ドル)以上の契約が必要です。
押さえておきたい未確定事項
Metaは「追加の安全性評価を含む完全なレポートは近日公開」としており、現時点で全項目の評価は出そろっていません。Fullの提供は月額プランに限られ、従量課金のAPIで使える時期も示されていません。Spark 1.3にあった、入力0.1ドル・出力0.2ドルでデータを製品改善に提供する安価な「Contributor」枠が、Wonderにも用意されるかは発表されていません。
次にやること
- Spark 1.3を使っている場合は、同じプロンプトでWonderを試し、品質の差が3倍超の料金に見合うかを1タスクあたりの費用で比べる
- 事実確認の比重が高い用途では、Wonder単体に任せず、検索ツールの併用か他社モデルでの照合を前提に設計する
- Claude CodeやCodexの代替を検討しているチームは、Muse Codeの月50ドルプランでWonder Fullを1カ月試し、自社リポジトリでの完了率を測る