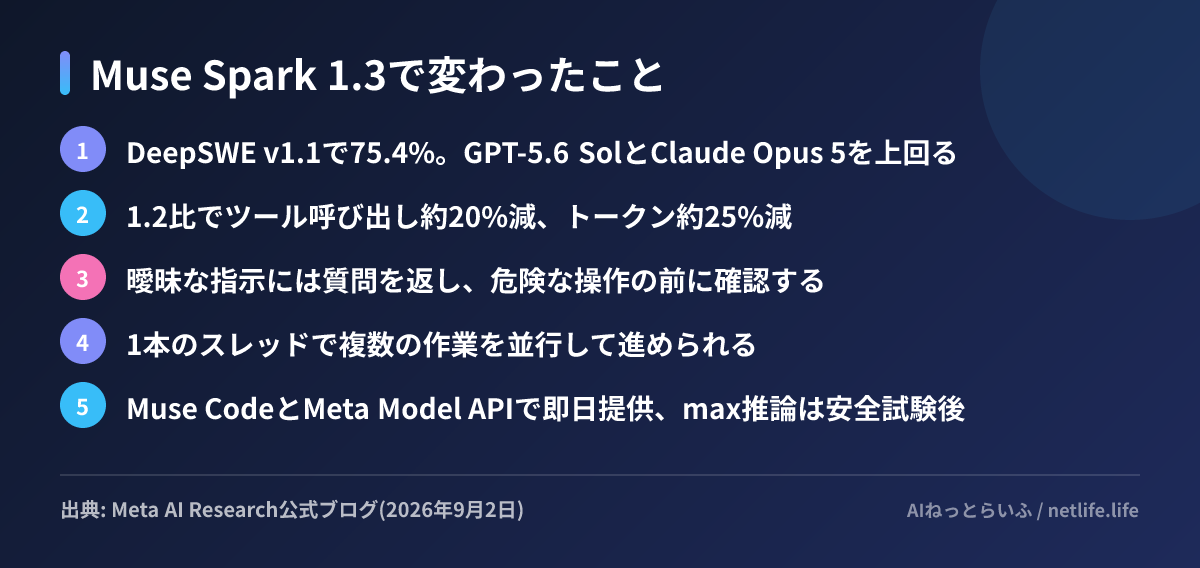
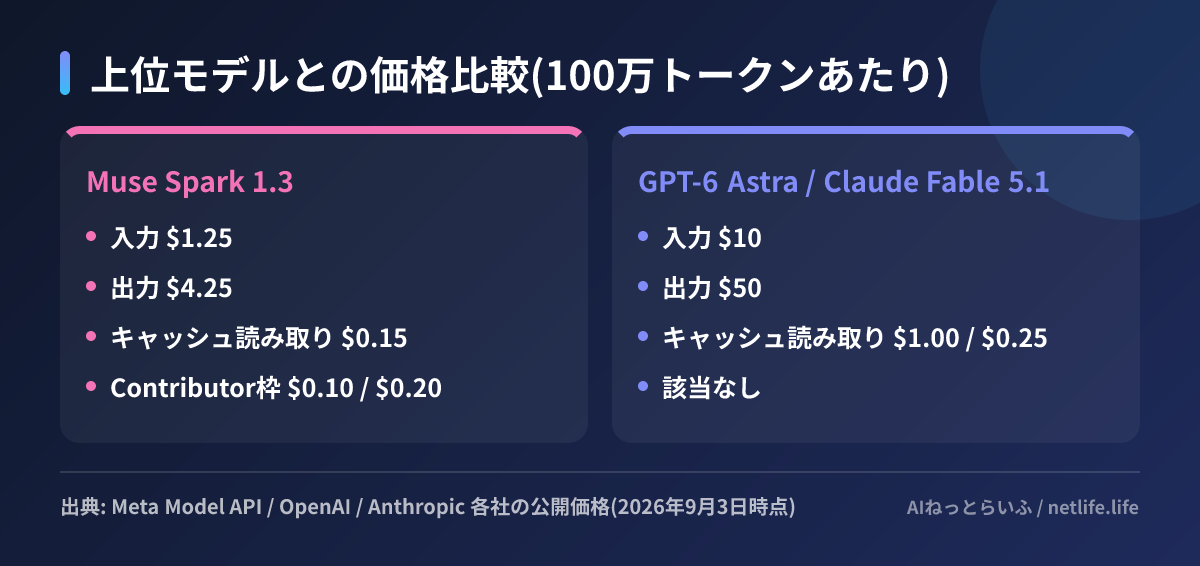
Metaは2026年9月2日、Meta Superintelligence Labsの開発モデル「Muse Spark 1.3」を発表し、同日からコーディングエージェントのMuse CodeとMeta Model APIで提供を始めました。ソフトウェア工学ベンチマークDeepSWE v1.1で75.4%を記録し、GPT-5.6 Sol(72.7%)とClaude Opus 5(74.0%)を上回ったほか、100万トークン級の長文検索でも高い精度を示しています。同じ週にAnthropicのFable 5.1(入力$10・出力$50)とOpenAIのGPT-6 Astra(同額)が出るなか、Muse Spark 1.3の価格は前バージョンと同じ入力$1.25・出力$4.25(100万トークンあたり)のままです。上位2社の8分の1の価格でコーディング評価の上位に並んだことが、この発表の要点です。
なぜ今、Metaの「1.3」が注目されるのか
Muse SparkはMeta Superintelligence Labsが開発するクローズドモデルの系列で、重みは公開されていません。これまでの版は「上位3社を追う立場」と見られてきましたが、1.3は第三者評価のArtificial Analysisが「Metaがフロンティアに到達した」と題する水準に上がりました。同サイトのIntelligence IndexでMuse Spark 1.3(xhigh)は61で、GPT-5.6 Sol(max)およびGrok 4.6(high)と同点。上にはClaude Fable 5.1の66とClaude Opus 5(max)の63があるだけです。Metaが同時に強調するのは効率で、社内エンジニアの評価ではMuse Spark 1.2に比べてツール呼び出しが約20%、トークン消費が約25%減ったとしています。
Meta AI責任者のAlexandr WangはAxiosの取材に対し、「フロンティアモデルと十分に競争できる」と述べたうえで、目標を「ユーザーの代わりに24時間働くパーソナルエージェント」に置いています。今回の1.3で追加された挙動、すなわち曖昧なプロンプトでは質問を返す、行き詰まったらユーザーの助けを求める、取り返しのつかない操作の前に確認する、といった項目は、その方向に沿ったものです。
ベンチマークの中身
発表文のスコア表(評価方法は別途資料で公開)の主要な数字を整理します。コーディングはDeepSWE v1.1が75.4%、コードベースに関する質問応答のSWE-Atlas Codebase QnAが59.4%、Terminal-Bench 2.1が88.8%(Solと同点、Opus 5は86.7%)です。長文脈の検索精度を測るMRCR v2は256K〜512Kトークンで98.5%、512K〜1Mトークンで98.1%と、Solの91.5%・73.8%を大きく上回ります。コンピュータ操作のOSWorld 2.0はmax推論で66.9%、xhighで57.2%です。
注意点が2つあります。第一に、比較対象が「GPT-5.6 Sol」と「Claude Opus 5」であり、今週出たばかりのFable 5.1とGPT-6 Astraは含まれていません。GPT-6 AstraはOpenAI自身の発表でDeepSWE v1.1が74.1%、OSWorld 2.0が72.6%なので、コーディングは僅差、コンピュータ操作はAstraが上、という見方が現時点では妥当です。第二に、最も高い数字を出すmax推論モードは「追加の安全試験が終わり次第」の提供で、発表時点では使えません。Artificial Analysisの測定では、maxはxhighより推論トークンを62%多く使うため、同じ価格でも1タスクあたりの費用は増えます。同サイトはxhighでの1タスクあたりの費用を$0.55とし、Intelligence Index 59以上のモデルの中で最も安いとしています。
価格と提供形態
価格はOpenRouterの掲載情報でも入力$1.25・出力$4.25・キャッシュ読み取り$0.15で、コンテキストは1,048,576トークンです。Meta Model APIには、入力$0.10・出力$0.20という桁違いに安い「Contributor」枠もあります。これは「プロンプトと出力がMetaの製品改善に使われることがある」条件で料金を下げるもので、Wangは開発者の採用率が「意味のある2桁」に達したと述べています。業務コードや顧客情報を扱う用途では、この枠は使えないと考えたほうがよいでしょう。重みは公開されておらず、Metaは「Muse Sparkのオープンウェイト版」と「より大きなモデル」を今後の予定として挙げるにとどめています。
日本の読者にとって
発表文に提供地域の制限は記載されておらず、Meta Model APIとMuse Codeは日本からも試せる見込みです。Muse CodeはmacOSとLinux向けにワンライナーでインストールでき、Windowsは発表文に記載がありません。1ドル150円の仮定で、入力100万トークンは約188円、出力100万トークンは約638円で、Fable 5.1やGPT-6 Astraの約8分の1です。Claude CodeやCodexに月数万円を払っているチームにとって、日常のコーディング作業をMuse Codeに寄せ、難所だけ上位モデルに回す構成を検討する材料になります。日本語での性能については発表文に記載がなく、実務での品質は自分のコードベースで試す必要があります。
一方で、判断を急がないほうがよい点もあります。max推論が未提供であること、比較対象に最新の競合が含まれていないこと、そしてGPT-6 AstraやFable 5.1のような監視・安全性の評価数値が今回の発表文にはほとんど示されていないことです。次にやることとしては、第一にMeta Model APIで既存のコーディングタスクを数十件流し、Sol比でのトークン数と成功率を記録すること。第二に、Contributor枠を使うなら社内規程とデータの種類を先に確認すること。第三に、上位モデルとの使い分けを決めるために、GPT-6 Astraの提供内容とFable 5.1の価格体系を同じ表で並べておくことです。