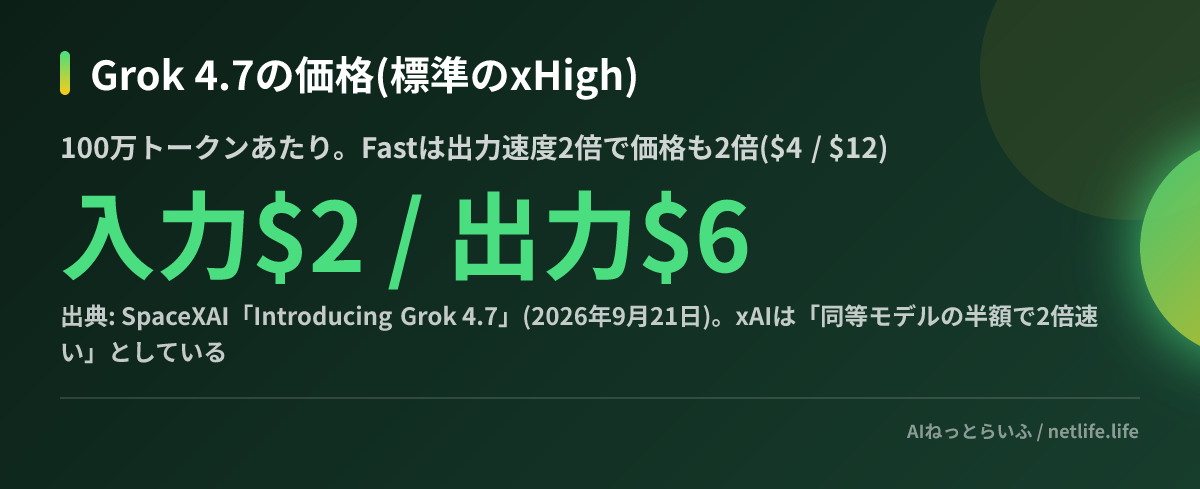
SpaceXAI(xAI)は2026年9月21日、コーディングと知識労働向けの新モデルGrok 4.7を公開しました。目を引くのは価格で、100万トークンあたり入力2ドル・出力6ドル。同日にGitHub CopilotのProからEnterpriseまでで選べるようになり、Cursorにも入りました。フロンティアモデルの半額以下で agentic coding(自律的にツールを使ってコードを書き進める使い方)を回せる選択肢が増えた、というのが実務上の意味です。一方で第三者の計測値はxAIの公表値より低く、どこに使うかは分けて考える必要があります。
何が変わったのか
xAIはGrok 4.7を「コーディングと知識労働において自社で最も高性能なモデル」と位置づけ、ベースモデルの大型化と強化学習の延長で作ったと説明しています。前世代のGrok 4.6からの伸び幅は、自社計測のベンチマークで一貫しています。
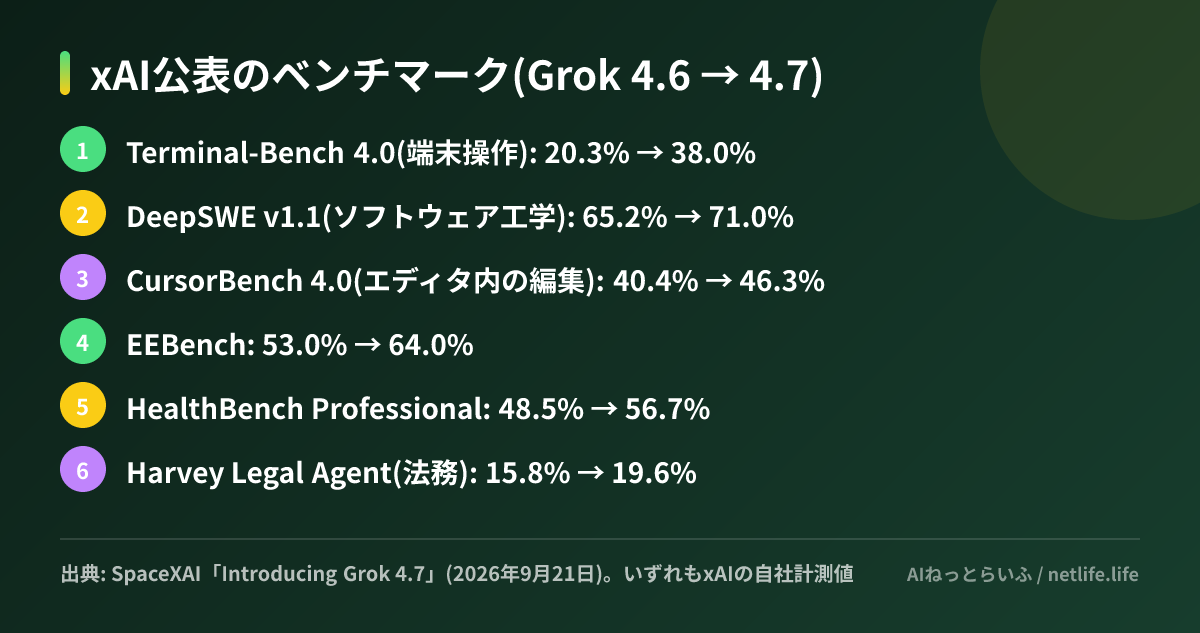
伸びが最も大きいのは端末操作を伴う長い作業(Terminal-Bench 4.0で20.3%から38.0%)で、xAI自身も「より長いコーディング作業に強い」と説明しています。提供形態は、標準のxHighに加えて出力速度が2倍の「Fast」があり、こちらは価格も2倍の入力4ドル・出力12ドルです。利用先はGrok API、Cursor、無料試用のあるGrok Build、および外部のコーディング環境やクラウドプラットフォームとされています。コンテキスト長は、第三者のArtificial Analysisの掲載値で50万トークンです。
公式値と第三者の計測にはひらきがある
ここは分けて読む必要があります。the-decoderの報道によると、独立系の評価サイトArtificial AnalysisのIntelligence Index v4.3.2で、Grok 4.7は46。Claude Fable 5.1とGPT-6はそれぞれ53でした。agentic codingのTerminal-Bench 4.0でも、同サイトの計測ではGrok 4.7が26%で、GPT-6 Astraの60%、Claude Fable 5.1の55%とは差があります。xAIの自社計測が38.0%なので、同じベンチマーク名でも計測条件によって数字が動いていることになります。
ベンチマークは実行時の足回り(ツールの与え方、リトライ回数、推論予算)で結果が変わるため、公式値と第三者値が一致しないこと自体は珍しくありません。ただ、ここでは差の向きが一貫して「公式値のほうが高い」ので、導入判断は自社のタスクで測り直してから行うのが安全です。the-decoderは価格帯が西側のフロンティアモデルより中国系モデルに近い点を指摘しており、性能差を価格で埋める位置取りだと考えられます。
CursorとCopilotに同日で載ったことの意味
配布面の動きのほうが、実は読みどころです。Cursorは現在SpaceX傘下で、xAIも「SpaceXAI」として同じ資本のもとにあります。当サイトで取り上げたとおり、OpenAIはCursorへのモデル提供を11月12日で終了します。つまりCursorのユーザーは、間もなくGPT系を選べなくなる。そこに自陣営の新モデルを当日から載せた形です。Cursorを使い続ける前提なら、Grok 4.7は「試してもいい選択肢」ではなく「残る選択肢のひとつ」になりつつあります。
GitHub Copilot側の扱いも確認しておく価値があります。GitHubのチェンジログによると、Grok 4.7はPro、Pro+、Max、Business、Enterpriseで利用でき、「usage-based billingのもとでプロバイダーの表示価格で課金」されます。対応環境はVS Code、Visual Studio、Copilot CLI、Copilotクラウドエージェント、Copilotアプリ、JetBrains、Xcode、Eclipseです。注意点として、新しいモデルは既定で有効になるため、組織として使わせたくない場合はBusiness/Enterpriseの管理者がモデルポリシーで明示的に無効化する必要があります。ロールアウトは段階的で、すぐに出てこない環境もあります。
複数モデルを使い分ける発想は、当サイトで紹介したGitHubのHydraFusionのように、実行時に自動で組み合わせる方向にも進んでいます。安いモデルが増えるほど、この「どれをどこに当てるか」の設計が効いてきます。
日本の読者にとっての使いどころ
日本語UIや日本リージョンについて、xAIの発表に特記はありません。Copilot経由で使う分には既存の契約と環境のまま増えるだけなので、導入の敷居は低いほうです。
現実的な当て方は3つに分かれると考えられます。第一に、量が出て失敗のコストが低い作業(テスト生成、リファクタリングの下書き、ログやコードの読解)には、価格差がそのまま効くので候補になります。第二に、成果物の正しさが直接効く長い自律作業では、第三者計測の差を踏まえると、いきなり主力に据えるのは早いと考えられます。第三に、Cursorを使っている組織は、11月12日以降のモデル構成を今のうちに決めておくべきです。
次にやることとしては、まず自社のリポジトリで実際のタスクを10〜20件用意し、現行モデルとGrok 4.7で同じ条件で走らせて、成功率と実コストを並べて記録してください。Business/Enterpriseの管理者であれば、モデルポリシーの既定有効という挙動を確認し、社内の許可モデル一覧を更新しておくことも忘れずに。