GitHubは2026年9月4日、GitHub Copilotの新機能「HydraFusion」を研究プレビューとして公開しました。開発者がモデルを1つ選ぶ代わりに、Copilot側がタスクごとに実行計画を立て、複数ベンダーのモデルを「下書き→批評→修正」や「軽いモデルで試して駄目なら強いモデルへ」という形で組み合わせます。GitHubの発表では、3つのコーディングベンチマークでClaude Opus 5と比べてコストを36〜67%削減し、品質は1つで上回り2つでほぼ同等でした。全Copilotプランで利用でき、Copilot CLIで実験機能を有効にすると選べます。「どのモデルを使うか」を毎回悩んでいる開発者と、Copilotの利用料を管理している人に関係する発表です。
単一モデルの選択から「実行計画」へ
GitHubは発表の冒頭で「タスクに最適なモデルを開発者に提供することが、常に私たちの目標だった」と書いています。しかし現在のCopilotでは20を超えるモデルが選べ、どれが自分のタスクに合うかを開発者が判断するのは難しくなっていました。強いモデルは高く、安いモデルは複雑なタスクで失敗する、という当たり前のトレードオフを、人間が毎回プルダウンで選ぶ方式には限界があります。
HydraFusionはこれを実行時のオーケストレーション(複数のモデルを役割分担させて1つの結果を作る仕組み)で解決しようとしています。タスクを受け取ると、推論・コード生成・デバッグ・ツール利用に関する「能力シグナル」を見て、3つの実行パターンから最も効率的なものを選びます。
1つ目は「Single」で、選んだ1つのモデルがそのまま解きます。2つ目は「Cascade」で、まず効率の良いモデルが下書きを作り、品質ゲートがそれを採用するか、より強いモデルにエスカレーションするかを決めます。3つ目は「Critique」で、1つのモデルが下書きを書き、独立した別のモデルが批評し、下書きを書いたモデルが1回修正します。どのモデルが組み合わせ候補に入っているかは発表では個別に明かされておらず、「複数プロバイダーのモデルから選ぶ」「新しいモデルがCopilotに加わったら評価して取り込める」という説明にとどまっています。品質ゲートが何を基準に採用と差し戻しを判断するかも公開されていません。
ベンチマークの数字をどう読むか
発表されたのは、ターミナル環境での多段階タスクを測る「TerminalBench 2.1」、大規模リポジトリを横断して修正する「DeepSWE」、そして実際のCopilotエージェントのセッションから作った社内ベンチマーク「CheckpointBench」の3つで、いずれもClaude Opus 5を基準にした比較です。
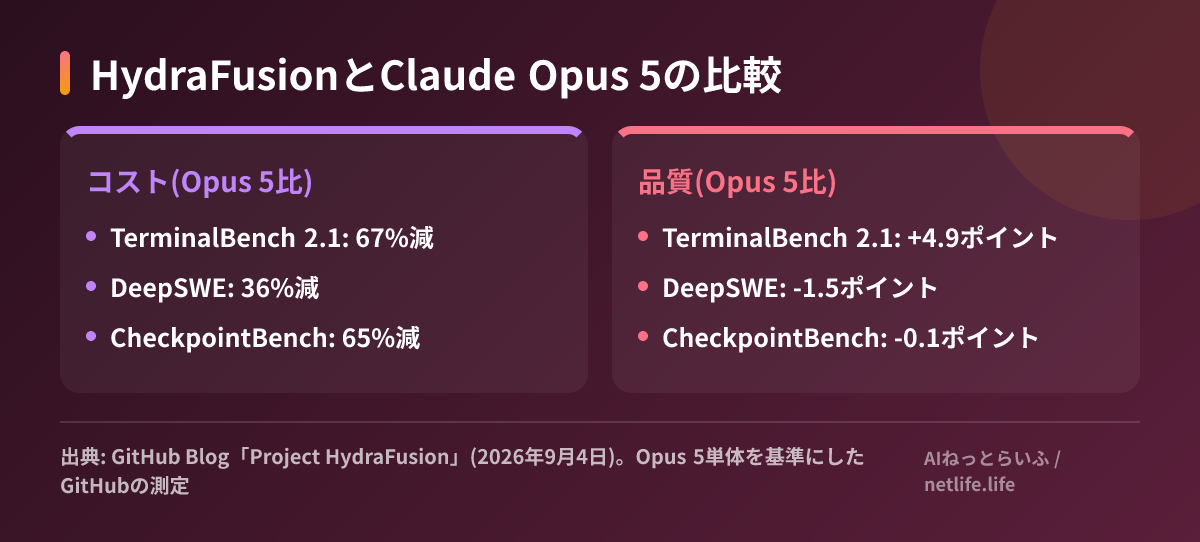
コストの測り方は明快で、「下書き、批評、修正、エスカレーション、リトライ、フォールバックといった呼び出しをすべて含めて」計算したとされています。複数回モデルを呼ぶ方式なのに合計が安くなるのは、多くのタスクが安いモデルで済んでいるからだと考えられます。
一方で、品質は「勝った」と言い切れる結果ではありません。3つのうちOpus 5を上回ったのはTerminalBench 2.1だけで、DeepSWEでは1.5ポイント下回っています。本番のセッションに近いとGitHub自身が説明するCheckpointBenchで-0.1ポイントというのは、実質的に互角と読んでよいでしょう。つまりこの発表の主張は「最高品質のモデルより賢い」ではなく「ほぼ同じ品質を、はるかに安く」です。GPT-5.6 Solも比較対象として名前が挙がっていますが、数値は公開されていません。また、レイテンシ(応答までの時間)については発表に記載がなく、複数モデルを直列に呼ぶCascadeやCritiqueでは単体より遅くなる可能性があります。
試し方と課金
利用できるのは現時点でCopilot CLIのみで、VS Codeや、GitHub上で動くコーディングエージェントについては言及がありません。
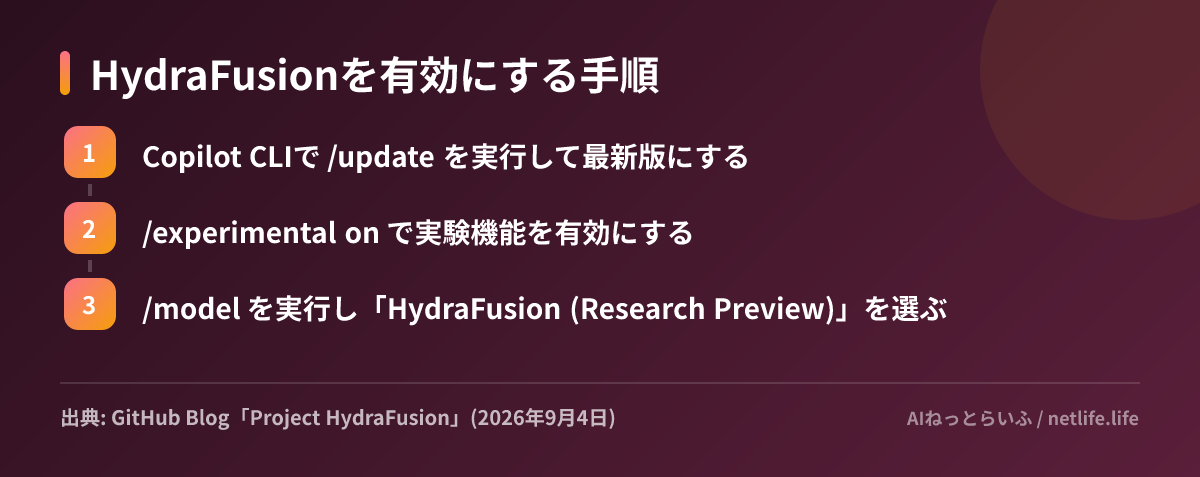
課金は「HydraFusionが使ったモデルが消費したトークンに基づき、各モデルの標準料金で」計算されます。HydraFusion固有の追加料金は書かれていませんが、逆に言えば「HydraFusionを選べば必ず安くなる」わけでもなく、Cascadeで強いモデルにエスカレーションされたタスクは単体で強いモデルを使うより高くつく可能性があります。
GitHubは現状の限界も明記しています。得意なのは「最初の1ターンで1つのプロンプトを与えるコーディングタスク」で、長い対話を続ける多ターンの性能は開発中です。実行中はワークフローの段階は表示されますが、途中の下書きは見せず、最後に1つのまとまった結果を返します。「結果、モデル、ワークフロー、提供状況、名前、製品の挙動は変わる可能性がある」と断っており、研究プレビューという位置づけどおり、本番の開発フローに固定するには早い段階です。
日本の読者にとって
Copilot CLIは日本からも通常どおり使えるため、有効化の手順は上記のままです。個人で試すなら、普段Opus 5やGPT-5.6 Solで解いている単発のタスク(テストの追加、CLIツールの作成、既知のバグ修正など)を何本かHydraFusionに流し、結果の差と消費トークンを見比べるのが早いでしょう。
組織で使う場合は、2つの確認が要ります。1つはモデル選択に関する社内ルールとの整合です。HydraFusionは複数ベンダーのモデルを動的に呼ぶため、「特定ベンダーのモデルのみ許可」という方針を持つ組織では、Copilotの管理者側でどう扱われるかを確認する必要があります。発表には管理者向けのポリシー設定の記載がないため、この点は現時点では不明です。もう1つはコストの可視化です。トークン消費が複数のモデルにまたがるので、利用状況のレポートで「どのモデルにいくら使ったか」が分かる形になっているかを見ておくと、後で説明がしやすくなります。
背景として押さえておきたいのは、GitHubが9月2日に別の記事で、出力の圧縮やプロンプトの短縮といった地道な工夫で3〜5%程度のコスト削減を積み上げていると説明していたことです。HydraFusionはその延長にある「モデルの選び方そのもの」でコストを下げる試みで、複数ベンダーのモデルを1つの製品の中で下書きと批評に分担させ、その数字を公開した点が目を引きます。
次にやることは3つです。第一に、Copilot CLIを更新してHydraFusionを1週間ほど普段の単発タスクに使い、品質とトークン消費を記録すること。第二に、多ターンの長い作業は当面、従来どおりモデルを指名して使い分けること。第三に、組織で導入する場合は、モデルの許可リストと利用レポートがHydraFusionを想定した形になっているかをCopilotの管理画面で確認することです。