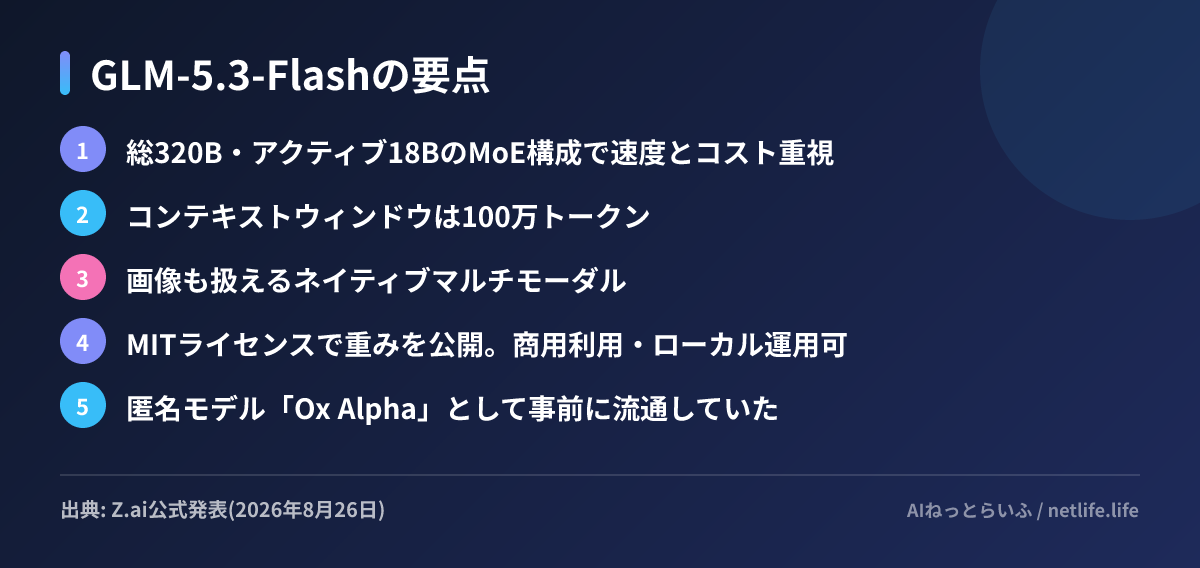
中国のAI企業Z.ai(Zhipu AI)は2026年8月26日、新モデル「GLM-5.3-Flash」を公開しました。数週間前からOpenRouterなどに匿名で登場し、正体不明のまま高評価を集めていた「Ox Alpha」の正体がこのモデルだったことも同時に明かされました。総パラメータ320B・アクティブ18BのMoE(混合エキスパート)構成で、100万トークンのコンテキストウィンドウを持つマルチモーダルモデルです。MITライセンスで重みが公開されており、商用利用やローカル運用が可能です。さらにZ.aiは、このモデルの推論が中国製AIチップのみで運用されていたと明らかにしており、モデル性能とは別の意味でも業界の注目を集めています。
モデルの中身
GLM-5.3-Flashは「Flash」の名のとおり、速度とコストを重視した設計です。アーキテクチャは、近距離の依存関係を線形アテンション、文書全体の把握をスパースアテンションで処理するハイブリッド構成で、これに「IndexPool」と呼ばれる圧縮機構を組み合わせています。Z.aiの説明では、GLM-5.3と比べてアテンションの計算量を3分の1に、KVキャッシュのサイズを4.4分の1に削減したとされています。100万トークンという長いコンテキストを現実的なコストで回すための工夫です。
ベンチマークでは前世代から大幅な伸び
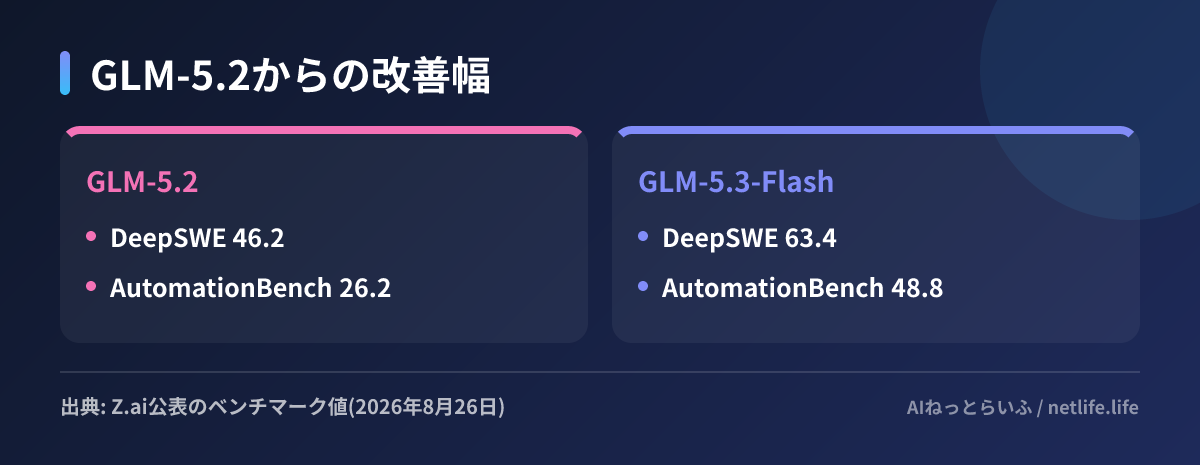
公表されているベンチマークでは、コーディングエージェント系の伸びが目立ちます。ソフトウェア修正タスクのDeepSWEでは63.4を記録し、GLM-5.2の46.2から大きく改善しました。PC操作の自動化を測るAutomationBenchでも26.2から48.8へほぼ倍増しています。第三者評価のArtificial Analysis Intelligence Indexではスコア57、タスクあたりコストは0.045ドルと、「そこそこ賢く、とにかく安い」領域を狙った位置づけです。
匿名の「Ox Alpha」時代に、開発者コミュニティが提供元を知らないままコーディング用途で高く評価していたことは、数字以上に説得力のある実地テストだったといえます。
「中国製チップのみで運用」の意味
今回の発表でZ.aiは、Ox Alphaとしての提供期間を含めて、このモデルの推論を中国製AIチップだけで賄っていたと明らかにしました。報道では約10万枚規模の国産チップで運用されていたとも伝えられています。米国の輸出規制でNVIDIA製GPUの調達が制限される中、フロンティア級に近いモデルを国産チップで大規模運用できると実証した形で、「誰も気づかないまま使っていた」という見せ方も含めて、規制環境下での技術力を示す狙いが明確です。AIインフラのNVIDIA一強構図が崩れるかどうかを占う事例として、モデル自体の性能とは別に記憶しておく価値があります。
日本の読者にとって
実務面では、MITライセンスでの重み公開が最大のポイントです。Hugging Faceから取得してvLLMやSGLangで自社環境にデプロイできるため、データを外部に出せない案件でも検討の土俵に乗ります。一方、Z.aiのAPIやアプリ経由で使う場合はデータが中国のサービスに送信されるため、業務データを扱うなら利用規約とデータの保存先を必ず確認してください。ローカル運用とAPI利用ではリスクの性質がまったく違う、という整理が実務では重要です。
日本語性能についての公式な言及は現時点でなく、GLMシリーズは歴代、日本語も一定水準でこなすものの英語・中国語が中心です。日本語の業務文書で使うなら自社タスクでの評価が先です。
次に何をすればいいか
コーディング補助のコストが課題のチームは、OpenRouterなどで少額から試して、普段のタスクでClaudeやGPTとの差分を確認してみてください。ローカルLLMを検討しているチームは、Hugging Faceのモデルカードで必要VRAMと推奨構成を確認し、まず量子化版で検証するのが現実的です。導入判断の前に、データ送信先の確認だけは省略しないでください。