
OpenAIは2026年9月8日、社内モデルを動かすエージェント群が、ミレニアム懸賞問題の一つ「ナビエ–ストークス方程式の存在と滑らかさ」を解決したと発表しました。静止状態から始まる滑らかな流体が有限時間で特異点(速度が無限大に発散する破綻)を生じうることを示す証明で、証明支援系Leanによる形式化も終えています。ただしOpenAI自身は懸賞金を請求しないと明言し、功績の所在をめぐっては当事者の主張が食い違っています。AIが未解決問題を「解く」段階に入ったことと、その成果を誰の手柄としてどう検証するかという運用面の問題が、同じ日に一緒に表面化した発表です。
何が示されたのか
ナビエ–ストークス方程式は、流体をひとつながりの連続体とみなしてニュートンの法則を当てはめた式で、航空機設計や気象予測、血流の解析に使われています。未解決だったのは、3次元の非圧縮性流体でこの連続体近似が破綻しうるか、という点です。粘性による均し効果があるにもかかわらず、流体の速度が有限時間で無限大に向かう「特異点」が生じるなら、そこでは方程式が流体を記述できなくなります。1934年にJean Lerayが弱い意味での解の存在を示したものの、滑らかさは決着せず、2000年にクレイ数学研究所が7つのミレニアム懸賞問題の一つに指定しました。
今回OpenAIが示したのは、渦が内側に巻き込みながら「スパゲッティのように」細く引き伸ばされ、中心部が縮みながら加速していく解です。エネルギーは有限のまま、外から加わる力も滑らかなのに、流体自身の運動によって速度が発散します。OpenAIによれば、この結果は公式の問題記述にある主張「C」(および「D」)を成立させるもので、CとDは「解が破綻することを示す」側、つまり反証の方向の主張です。エージェント群は「A・B」(滑らかさの証明)と「C・D」の両方向に分かれて取り組んだと説明されています。
1万エージェントを88時間走らせた
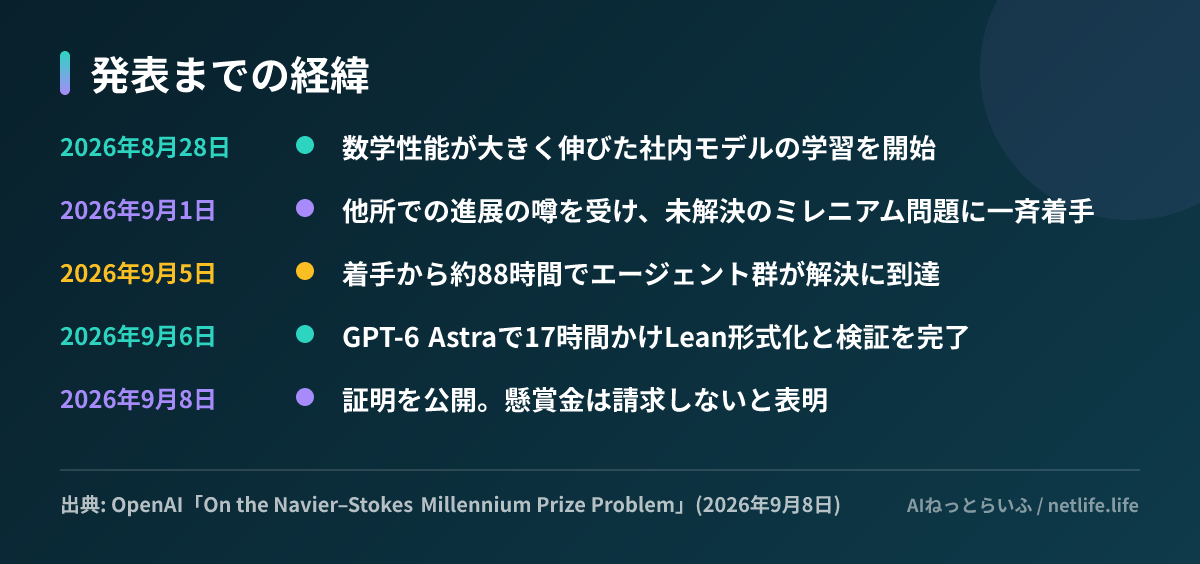
手法の側も具体的に公開されています。8月28日から学習を始めた社内モデル(OpenAIは「GPT-6 Astraよりも大幅に高性能」としています)に、インターネット接続とコード実行を与え、グループ内で通信させながら並列に走らせました。ナビエ–ストークスに割り当てられたのは約1万体の同時実行エージェントです。
途中で方向が変わっています。「より易しい」問題として粘性のないオイラー方程式にも約100体を当てていたところ、外力なしのオイラー方程式が約50時間で予想外に解けました。この結果を見たチームがナビエ–ストークスへ資源を寄せ、以降のプロンプトにオイラーの解決内容を含めたといいます。グループごとに異なる筋道を探らせ、有望な知見はCodexが横断的に集約しました。
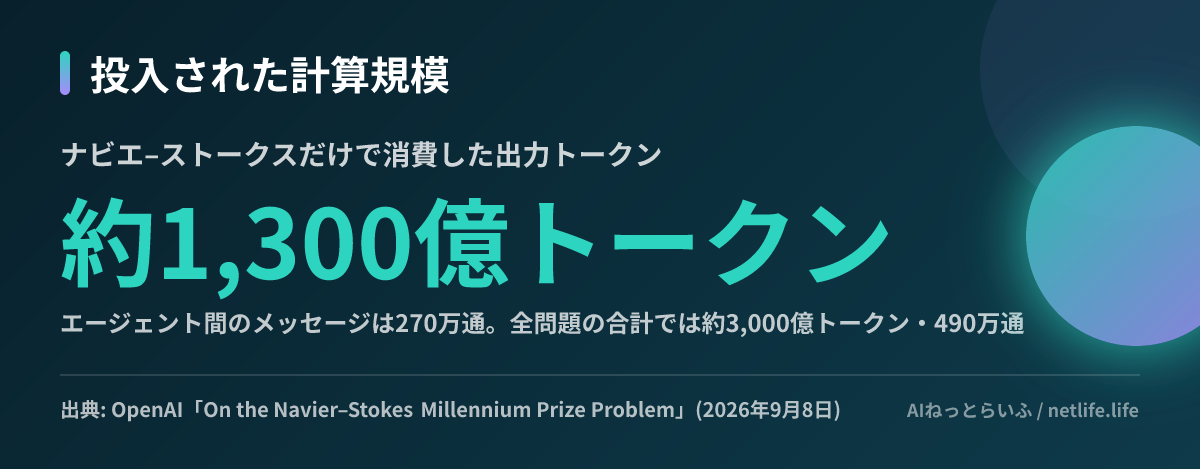
エージェント数だけを見ると別世界の話に見えますが、構造としてはClaudeによるフェルマーの最終定理の形式化と同じで、「正誤を機械的に判定できる領域で、多数のエージェントを日単位で協調させる」という形です。違いは、形式化(既にある証明を機械可読にする)ではなく、証明そのものを見つけに行った点にあります。
功績をめぐって主張が食い違っている
同じ週、Anthropicに所属するLevent Alpöge氏とニューヨーク大学のTristan Buckmaster氏が、外力付きのオイラー方程式などで有限時間の破綻を示す結果を公開しました。テレンス・タオ氏は自身のブログで、この仕事がDiego Córdoba氏とLuis Martínez-Zoroa氏の手法の上に立つものだと紹介し、「議論は大いにAIの助けを借りているが、著者らはこの数週間、彼ら自身が『数学史上最悪の書き上げ』と呼ぶものから証明を簡略化し書き直す作業を続けてきた」と書いています。タオ氏は同時に、こうした仕事の主な価値は問題を解くこと自体ではなく数学的な理解と洞察を育てることにある、という立場も示しています。
OpenAI側も、9月1日に着手したきっかけが両氏に関する噂だったことを認め、完成後に連絡を取ってオイラー方程式での先行を認めたと説明しています。これに対しBuckmaster氏は、自分たちがCodex上で行ったセッションにOpenAIのモデルが接触していないかを問い、納得できる回答を得られなかったとFortuneに述べています。プロジェクトを率いたSebastien Bubeck氏は「我々は彼らのプロンプトや証明を、モデルへの入力にもエージェントの誘導にも使っていない」と否定しています。どちらの主張が正しいかは現時点で外部から判定できません。
検証の状況も押さえておく必要があります。クレイ研究所の公式問題記述を書いたプリンストン大学のCharles Fefferman氏は「問題が解かれて胸が躍った」とQuanta Magazineに語っていますが、同記事は、Leanで検証済みであっても「Leanで真だと示された主張が、数学者が証明しようとしていたものと論理的に同値かどうか」は人間が確かめる必要があると指摘しています。形式検証が保証するのは「書かれた主張から結論への推論が正しいこと」であって、「書かれた主張が目的の命題そのものであること」ではない、という区別です。
日本の読者にとって
直接の実務インパクトが大きいのは、二段構えの検証という考え方です。AIに大規模な成果物を作らせるとき、テストや型検査、形式手法のように機械が判定できる形に落とすところまでは多くの現場が既にやっていますが、「その判定対象が本当に満たしたい要件か」を人が読む工程は抜けがちです。今回はLean検証済みの証明ですらそこが論点になりました。社内でAI生成物を受け入れる基準を作るなら、機械検証の合格と要件の一致確認を別の工程として分ける価値があります。
もう一つは、業務で使うAIコーディング環境のデータ取り扱いです。今回の争点の一つは「自分たちがそのベンダーのツール上で行った作業が、ベンダー側の開発に影響していないか」でした。真偽は不明ですが、研究や未公開の開発をAIツール上で進めている組織にとっては、契約上のデータ保持・学習利用の条件を改めて確認する理由になります。OpenAI自身、主任科学者が能力向上のペース配分に言及しているように、今回の発表文も「進歩のペースを意図的に選ぶ必要があるかもしれない」と結んでいます。
次にやることを3つ挙げます。第一に、AI生成物のレビュー基準を持っている組織なら、「機械的な合格条件」と「要件との一致を人が確認する条件」が分けて書かれているかを見直すこと。第二に、社外に出せない検討をAIツール上で行っている場合、そのプランのデータ保持・学習利用の条件を契約書で確認すること。第三に、数学や形式手法に関わるなら、タオ氏のブログとOpenAIの発表文の両方を読み、「解けたかどうか」と「理解が進んだかどうか」を分けて評価する視点を持っておくことです。


