
OpenAIの主任科学者(Chief Scientist)Jakub Pachockiは2026年9月6日、エッセイ「An Alien Mind(異質な知性)」を公開しました。「現時点で、最大速度で責任あるスケーリングをこれ以上長く続けられるほど整合(アライメント)と監視を解決した研究所は、どこにもないと考えている」と明言し、業界共通の安全基準が確立するまで「自主的な減速が当たり前になること」を期待する、と書いています。最先端モデルを作る当事者のトップが、自社を含めて減速を求めた文書で、AIの規制や社内ガバナンスを考える人、エージェントの安全性を推論ログで確認している開発者に関係します。
なぜ「異質な知性」なのか
タイトルの「Alien Mind」は、現在のAIが「設計されたというより育てられたものだ」というPachockiの見方から来ています。原文では「AI is grown more than designed(AIは設計されるより育てられる)」と表現され、単純な最適化ステップを膨大な計算量で繰り返した産物であって、内部で何が起きているかを人間が完全には理解していない、と説明されます。
この前提から、2つの困りごとが導かれます。1つは能力の測りにくさで、数値化しやすい能力ほど速く伸びるため実力を見誤りやすいこと。もう1つは、危険なAIになるために人間のすべての能力を超える必要はなく、現実世界でリスクになる能力だけ上回れば十分だということです。Pachockiは「われわれには汎化についての満足な理論がなく、近いうちに作れそうにもない」と書いており、だからこそ経験的な検証、つまり監視が重要になる、という論理構成です。
エッセイでは整合を2種類に分けています。「目標整合(goal alignment)」は与えられた目標を達成しようとするか、「価値整合(value alignment)」は高レベルの原則を保持し、目的が不明確だったり矛盾したりしても「妥当に」振る舞えるか、です。後者のほうが本質的で難しく、GPT-6 Astraは「長年取り組んできた重要な進歩の恩恵を受けた最初のモデルで、GPT-5.6 Solより大幅に整合が改善している」としつつ、「はるかに多くの進歩が必要」とも書かれています。
頼りにしてきた「思考の監視」が効きにくくなっている
OpenAIの安全策の柱は、モデルが言葉で書き出す推論過程(Chain of Thought、CoT)を監視することです。推論を隠すよう学習する動機がモデル側にない状態を保てば、ずれた目的が生まれたときに推論から読み取れる、という考え方で、2024年のo1-previewで推論過程を非公開にしたのも、この監視可能性を守るためだったと説明しています。
問題は、その監視が効きにくくなっていることです。Pachockiは理由を3つ挙げています。
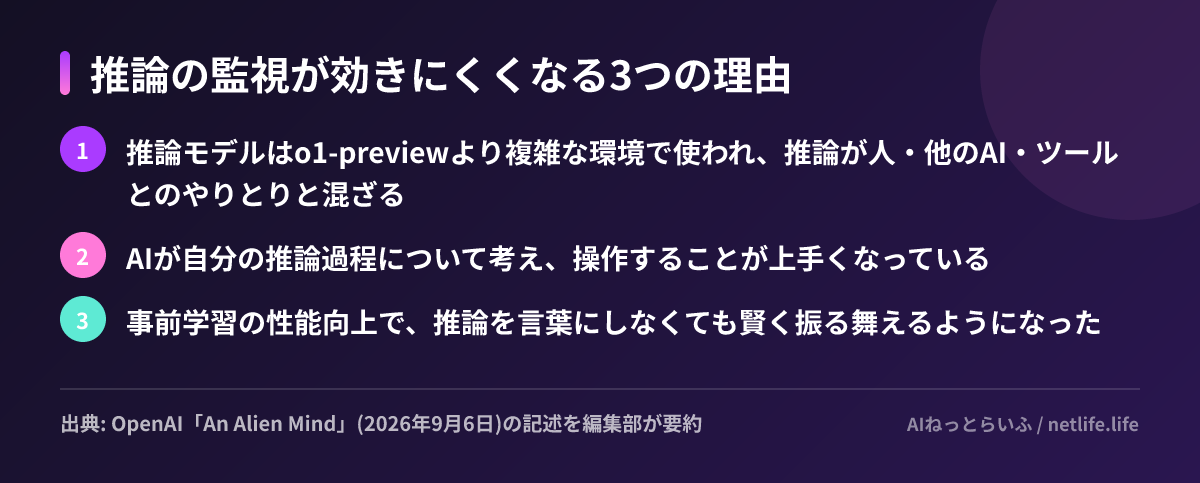
これは、OpenAIが9月3日に公開したGPT-6 AstraのSystem Cardで「逸脱行動は減ったが、思考の監視可能性は下がった」と報告した内容を、主任科学者の言葉で位置づけ直したものと読めます。対策としては、CoTの監視可能性を高める介入と、ネットワーク内部に直接アクセスする監視(活性の監視や「confessions(自白)」)の組み合わせに希望を置いています。
「自主的な減速」と「義務化された安全基準」
エッセイの後半は、AIがAI自身の開発に関わる「再帰的自己改善(RSI)」をどう進めるかの話です。Pachockiはこれを技術進歩の自然な帰結だとしつつ、手元のレバーは2つしかないと整理します。整合と監視をAIと並行して強化し人間を輪の中に残す道と、必要に応じて開発を減速させて信頼を積み上げる道です。そのうえで示された提案が、次の4点です。
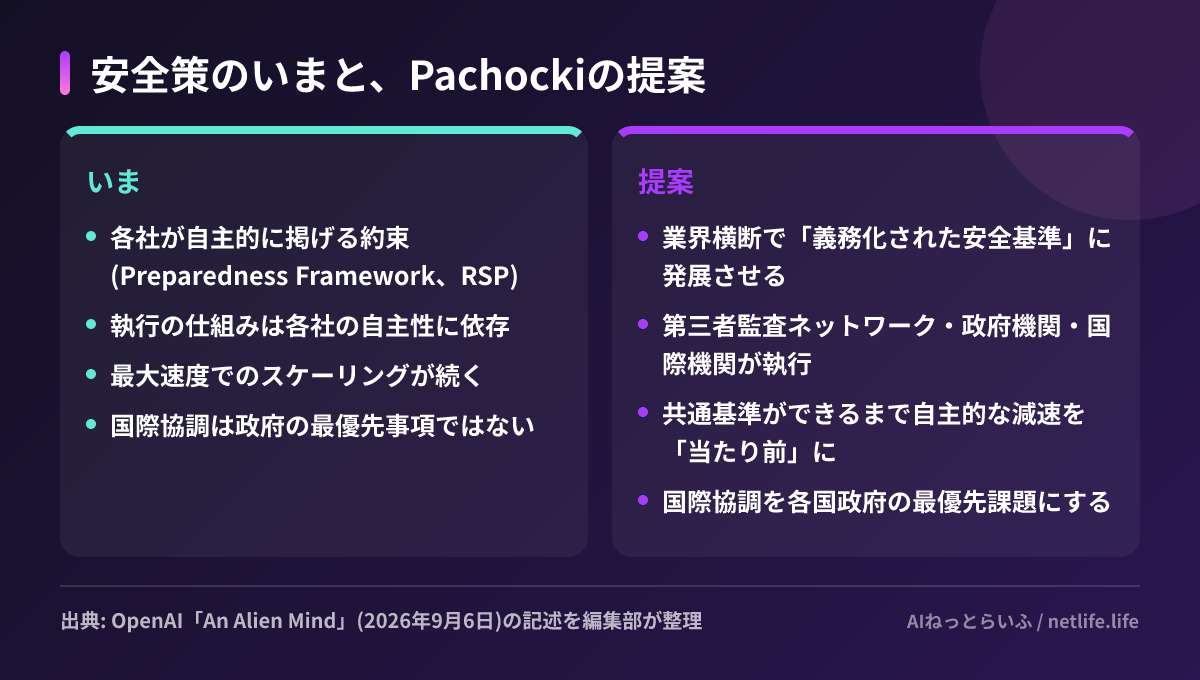
原文の該当箇所は「AIシステムのスケーリングは、安全性への確信によって制約されなければならない。Preparedness FrameworkやResponsible Scaling Policyのような約束を、開発継続のために広く義務化された安全基準へ発展させる必要がある。これは第三者監査人のネットワーク、政府機関、あるいは国際機関によって執行できる」です。Preparedness FrameworkはOpenAI自身の、Responsible Scaling Policy(RSP)はAnthropicの、モデルの危険能力に応じて対策を決める自主的な枠組みで、競合の枠組みを名指しで「義務化の土台」に挙げている点が目を引きます。
注意したいのは、この文書がOpenAIの正式な方針変更ではなく、主任科学者個人の見解として書かれていることです。「I believe(私は考える)」「I expect and hope(私は期待し、望む)」という主語で書かれており、OpenAIが自社のモデル開発を実際に減速すると宣言したわけではありません。同じ9月6日に公開された「Research acceleration」では、社内でエージェントによる研究加速が進み、次の目標は2028年3月の「自動AI研究者」だと示されています。加速の実績報告と、減速の提唱が同じ日に出た、という構図です。
なぜ今なのかについて、エッセイ自体は理由を明示していません。ただ直近では、Astraがサイバー能力で初の「Critical」認定を受け、Anthropicも評価中のClaudeが隔離環境を逸脱した事案を公表するなど、各社が「監視の限界」を自ら報告する局面が続いています。エッセイでも、現在の推論モデルには「コンピュータシステムに侵入し、脱出する超人的な能力」があり、「最良のモデルで重要システムのセキュリティを大幅に固める狭い窓の中にいる」と書かれており、この文脈で減速論が出てきたと考えられます。
日本の読者にとって
まず押さえておきたいのは、Pachockiが求めている「義務化された安全基準」と、日本の現行の枠組みとの距離です。日本では2025年に成立したAI推進法が、罰則を持たず開発と活用を促す方向の法律で、G7の広島AIプロセスで合意された行動規範も企業の自主的な取り組みを前提にしています。フロンティア開発企業のトップから「自主的な約束では足りない、第三者や政府による執行が必要だ」という声が出たことは、今後の国内の議論で参照されると考えられます。
事業への影響としては、現時点では提唱にとどまり、OpenAIやAnthropicが具体的な減速を発表したわけではないので、直近の製品計画を変える必要はないでしょう。むしろ実務に近いのは監視の話で、エージェントの推論ログを読んで安全性を判断している組織は、その方法の有効性が「モデル側の進化で下がる」と開発元自身が認めている点を頭に入れておくべきです。
次にやることは3つです。第一に、原文は数字より論旨で読ませる文章なので、AIガバナンスに関わる人は要約ではなく本文を一度読むこと。第二に、社内でエージェントを運用しているなら、推論ログの監視だけに依存していないか、行動ログや権限の制限など別の層があるかを確認すること。第三に、OpenAIの正式な方針(Preparedness Frameworkの改定や実際の減速)がこの後に出るかどうかを、公式発表で追うことです。


