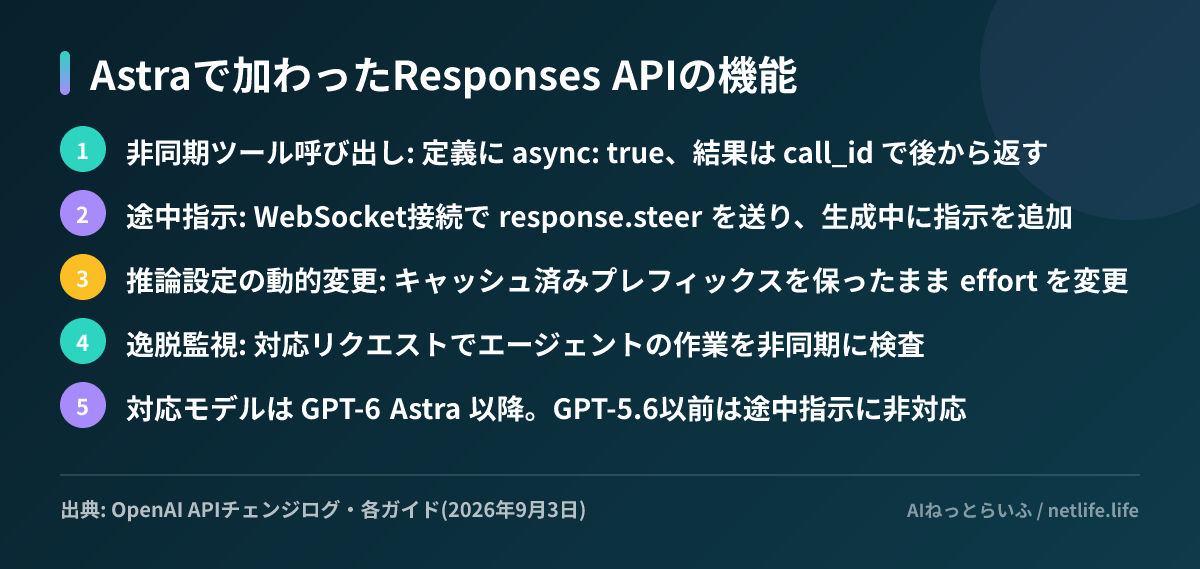
OpenAIは2026年9月3日、GPT-6 AstraのAPI提供に合わせてResponses APIに3つの機能を追加しました。ツールの実行を待たずにモデルが推論や別のツール呼び出しを続ける「非同期ツール呼び出し」、生成の途中でユーザーの指示を差し込める「途中指示(mid-turn steering)」、キャッシュを保ったまま会話の途中で推論の強さを変える「推論設定の動的変更」です。同時に、Astraではtemperature・top_p・logprobsが使えなくなり、ツール呼び出しはResponses API限定になりました。GPT-5.6 Solからモデル名を書き換えるだけでは動かないコードがある、というのが開発者にとっての実務上のポイントです。Model guidanceとAPIチェンジログをもとに整理します。
なぜ「待たない」設計が必要になったのか
Astraは9月3日の提供開始で、コンピュータ操作を含む長時間のエージェント作業を主戦場に据えました。この種の作業では、外部APIの応答やビルドの完了、人間の承認といった待ち時間が大半を占めますが、従来のツール呼び出しは結果が返るまでモデルが完全に停止する同期型でした。OpenAIはAstraの発表で「Codexでは、Astraはあなたの返答に依存しない作業を続けながら、非同期に質問できる」と説明しており、今回のAPI機能はその仕組みを開発者にも開いたものです。対応するリクエスト内でエージェントの作業を非同期に検査する「逸脱監視」も同時に加わりました。
非同期ツール呼び出しの仕組み
ガイドによると、対応モデルは「GPT-6 Astra以降」です。使い方は、function toolまたはcustom toolの定義にasync: trueを付けるだけで、モデルはその呼び出しを発行した後、アプリケーションが出力を返す前に作業を続けます。実行はこれまで通りアプリケーション側の責任です。結果はfunction_call_outputまたはcustom_tool_call_outputとして、元のcall_idを添えてprevious_response_id付きの次のリクエストで返します。
推奨は、wait_for_tasksのような待機用ツールを自前で用意し、複数の照会を先に投げてから必要な時点で結果を待たせる形です。制約として、Web検索などOpenAIがホストする組み込みツールとは併用できず、プログラマティックなツール呼び出しとの組み合わせや、マルチエージェント構成で並列ツール呼び出しと混ぜることは避けるよう案内されています。
途中指示は「取り消し」ではない
途中指示のガイドでは、対応はgpt-6-astraのみで、WebSocket接続のResponses APIに限られます。previous_response_idとinputを含むresponse.steerイベントを送ると、APIはresponse.steer.acceptedを返します。ツール結果や承認も同じパターンで差し込めます。
注意すべきは、受理は「キューに入った」ことを意味するだけで、モデルがすでに反応したわけではない点です。ガイドは「途中指示は、すでに送られた出力を書き換えたり、先に実行した操作を取り消したり、開始済みのツールをキャンセルしたりはしない」と明記しています。差し込んだ指示は現在の接続上にしか存在せず、切断すると失われます。「やり直し」ではなく、走っているエージェントの向きを変える道具であり、破壊的な操作を止めるガードはツール側に置く必要があります。
移行で外れるもの、変わるもの
Model guidanceの移行手順は具体的です。modelをgpt-6-astraにしたうえで、temperature・top_p・top_logprobsを削除し、ツール呼び出しはResponses APIに寄せます。prompt_cache_retentionはprompt_cache_options.ttlに置き換え、値は"30m"を指定します。推論の強さにnoneは指定できず、EUデータレジデンシーではFast modeが使えません。
料金と上限はモデルページのとおり、入力$10・キャッシュ入力$1・キャッシュ書き込み$12.50・出力$50(100万トークンあたり)で、入力が272,000トークンを超えるリクエストは入力とキャッシュが2倍、出力が1.5倍になります。コンテキストは1,050,000トークンですが、この閾値を超えると単価が跳ねるため、長い会話は圧縮(compaction)を挟む前提で組む必要があります。ファインチューニングと蒸留は非対応です。
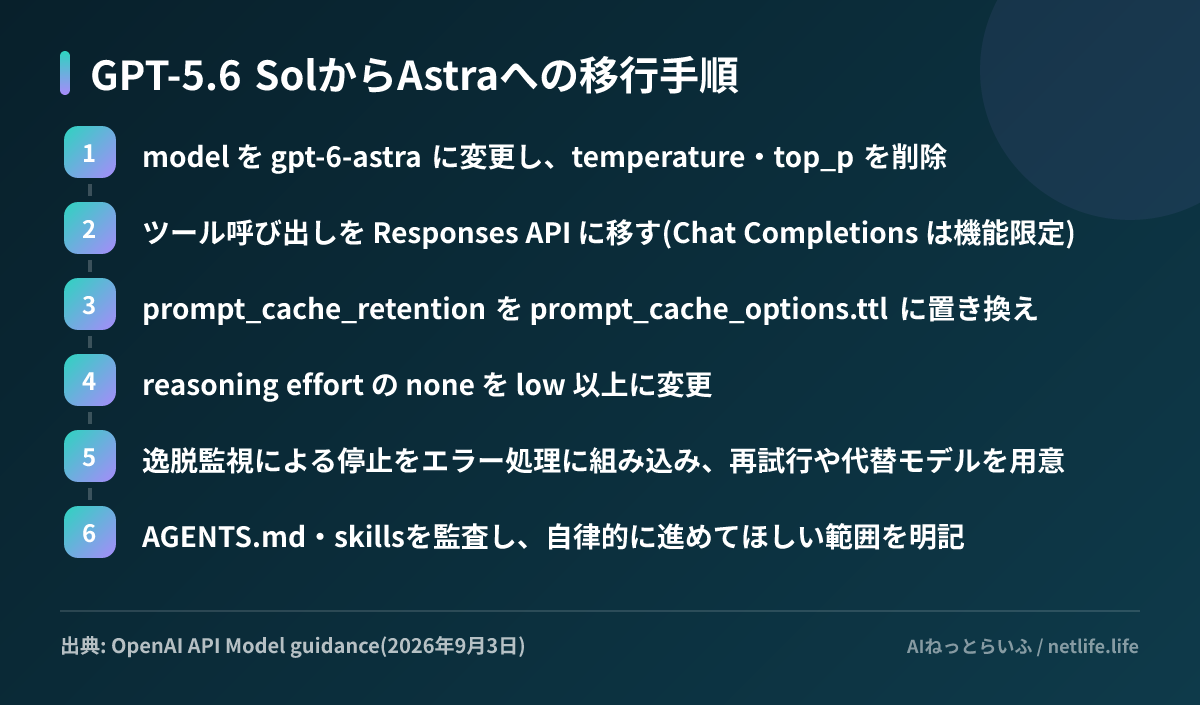
プロンプトの調整も必要です。Model guidanceによると、Astraは前モデルより確認の質問をしやすく、自律的に進めさせたい場合はその旨を指示する必要があります。skillsやAGENTS.mdのようなファイル内の指示に敏感で、OpenAIは「振る舞いに影響しうる指示がないか、モデルがアクセスできるファイルを監査することを強く推奨する」としています。サブエージェントへの委譲は減る傾向があるため、並列作業は明示的に指示するよう案内されています。
日本の読者にとって
日本からの利用に制限はなく、Microsoft AzureとAmazon Bedrockでも提供されます。対象となるAPI顧客はZero Data Retention(入出力をOpenAI側に保存しない設定)を利用でき、安全監視と顧客データの分離を両立する「Private Safety Processing」はテスト中とされています。
コスト面では、OpenAIの「テストした他モデルより最大20%少ないトークンで済む」という主張と、第三者評価機関Artificial Analysisの9月3日の計測が食い違っています。後者では、最大推論設定での出力トークンはSol比で約10%減にとどまり、単価上昇のためタスクあたりのコストは前モデルより75%高くなったとしています。同じ計測でAstraの総合スコアは61でSolと同点、Claude Fable 5.1は66、Gemini 3.8 Flashは59でした。一方でOpenAI公表のTerminal-Bench 4.0では57.9%(Fable 5.1は55.8%)、DeepSWE v1.1では74.1%(同67.4%)とAstraが上回っています。
次にやることは3つです。第一に、既存コードからtemperatureとtop_pを検索し、Astraに切り替える箇所を洗い出すこと。第二に、外部APIの待ち時間が長いエージェントを1つ選び、async: trueを付けて同じタスクの所要時間とトークン数を計測すること。第三に、モデルが読めるAGENTS.mdやskillsファイルを棚卸しし、意図しない指示が混ざっていないかを確認することです。これは安全上の推奨であると同時に、出力の質にも直結する作業だと考えられます。