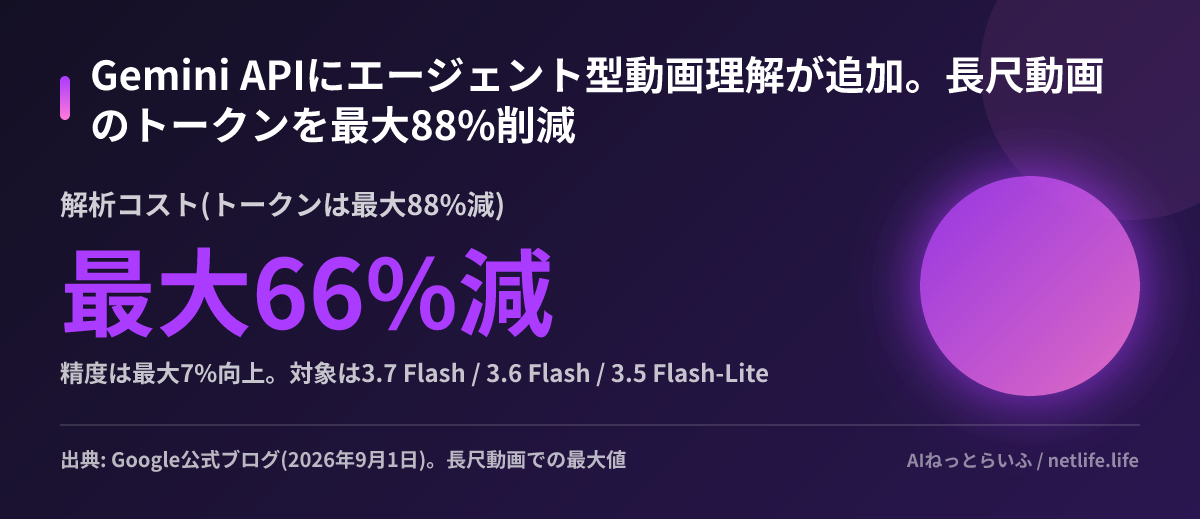
Googleは2026年9月1日、Gemini APIの動画入力に「agentic video understanding(エージェント型動画理解)」を追加しました。従来の動画入力は、動画全体を毎秒1コマなど固定のレートでトークン化してモデルに流し込む方式でしたが、新方式ではモデルが目的に応じて「どの区間を、どの速さで、映像・音声・書き起こしのどれで」見るかを自分で決めて取りに行きます。Googleによると長尺動画では解析コストが最大66%、トークン消費が最大88%減り、精度は最大7%向上します。対象はGemini 3.7 Flash、3.6 Flash、3.5 Flash-Liteの3モデルで、Google AI StudioとGemini Enterprise Agent PlatformのGemini APIから即日利用可能、追加料金はありません。動画をAPIに投げている開発者にとっては、コード1行の変更で請求額が変わりうる話です。
「全部読む」方式の限界
これまでGeminiに動画を渡すと、モデルは動画を既定で1FPS(1秒あたり1フレーム)の固定レートで取り込んでいました。APIでレートは変えられますが、動画の内容を見て途中で変えることはできません。この方式には構造的な弱点があります。1時間の動画なら3,600フレームぶんのトークンが、質問に無関係な区間も含めて必ず発生します。逆に、コストを抑えるためにフレームレートを落とすと、一瞬しか映らない重要な場面を取りこぼします。Googleは発表文で、開発者が「高いトークンコストを払うか、重要な細部を失うか」の二択を強いられてきたと整理しています。
10分程度のチュートリアル動画から数時間の会議録画まで、長い動画ほどこの矛盾は大きくなります。今回の変更は、この前提そのものを変えるものです。
モデルが「見る場所」を選ぶ
新方式では、モデルは動画をいきなり全部取り込むのではなく、まず動画の時間軸を探索します。必要に応じて書き起こしを取り、当たりをつけた区間だけフレームを要求し、動きが速い場面ではフレームレートを上げて再サンプリングする、といった手順をモデル自身が組み立てます。映像・音声・書き起こしの3つのモダリティ(情報の種類)から、質問に答えるのに必要なものだけを選ぶ点が「エージェント型」と呼ばれる理由です。
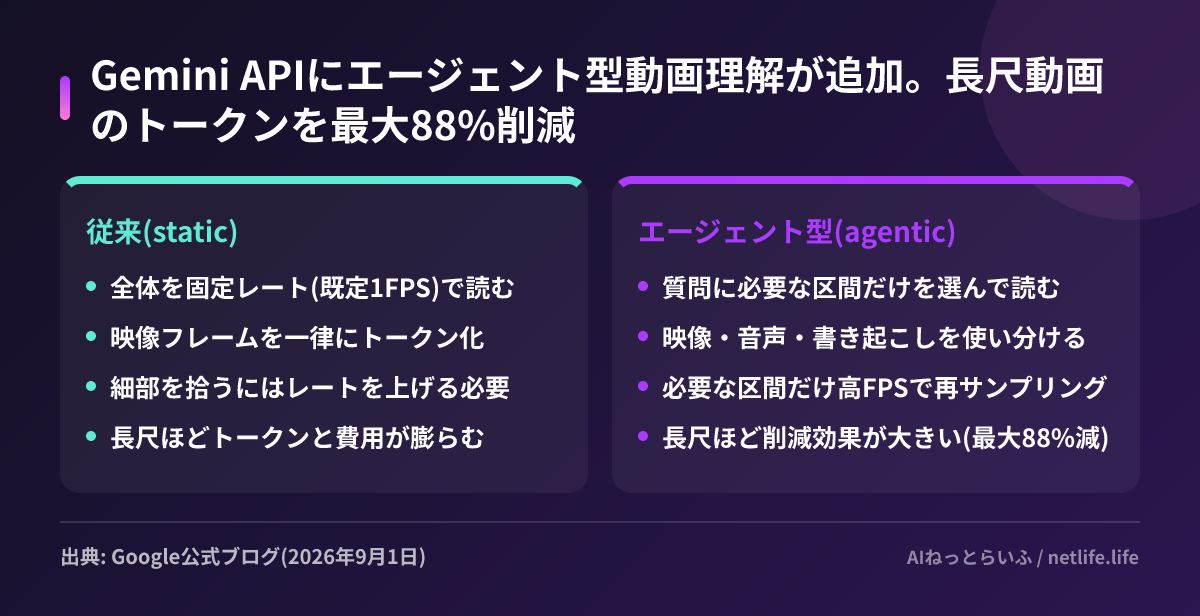
Googleが挙げている用途は4つです。動画編集の自動化に向けたサブ秒単位での場面特定、数時間の動画から特定の瞬間を探し出す検索、高いフレームレートでの再サンプリングによる異常検知、そして繰り返し動作や物体の正確なカウントです。いずれも「一部の区間だけを高解像度で見たい」タスクで、全体を均一に読む方式が最も不利だった領域と重なります。
なお、トークンの削減率(最大88%)に対して費用の削減率(最大66%)が小さいのは、モデルが探索のための推論やツール呼び出しを行い、その出力トークンが課金に加わるためと考えられます。発表文に内訳の記載はないため、実際の削減幅は動画の長さと質問の性質で変わるとみておくのが安全です。
有効化はパラメータ1つ
開発者側の変更は小さく、動画パートに"processing": "agentic"を指定するだけです。発表文に示されている例は次のとおりです。
{
  "type": "video",
  "uri": "https://youtu.be/7Z5Vy9JBANs",
  "processing": "agentic"
}
アップロードした動画ファイルとYouTubeのURLの両方に対応し、料金は通常のGemini APIのトークン単価のまま、機能に対する追加料金はありません。Gemini APIのリリースノートによると、Interactions APIとGenerateContent APIの両方で使えます。3モデルのうちGoogleは3.7 Flashを「精度とコストのパレートフロンティア上にある」最良の選択肢としています。エンドユーザー向けには、Geminiアプリへの展開が「近く」、YouTubeの動画ページで内容を質問できる「Ask YouTube」機能への搭載が「今後数か月以内」と予告されています。
日本の読者にとって
日本からもGoogle AI StudioとGemini APIで即日使えます。対応3モデルの中で最上位の3.7 Flashは、入力$0.75・出力$3.75(100万トークンあたり、2026年末までの導入価格)で、1ドル150円と仮定すれば入力100万トークンあたり約113円です。会議録画の要約、研修動画からの手順抽出、店舗や工場の監視映像からの異常検知、YouTube動画の内容確認といった用途で、これまで「動画は高いから書き起こしだけ渡していた」チームが、動画そのものを渡す選択肢を再検討できる水準です。日本語の音声や字幕をどの程度うまく書き起こしとして使えるかは発表文に記載がなく、自分の動画で確かめる必要があります。
なお、9月2日に発表されたGemini 3.8 Flashは、この発表文の対象モデル一覧には含まれていません。3.8 Flashで同機能が使えるかは、公式ドキュメントの更新を待つ必要があります。
次にやることは3つです。第一に、すでに動画をGemini APIに渡している処理があれば、processingをagenticにして同じ動画・同じ質問で使用トークンと回答の正確さを比較すること。特に10分を超える動画で差が出るはずです。第二に、逆に短い動画や「全フレームを均一に見たい」タスク(例: 全体の雰囲気の判定)では従来方式のほうが向く可能性があるので、一括で切り替えず用途ごとに判断すること。第三に、費用の見積もりは「最大66%減」ではなく、自社の動画で実測した削減率を使うことです。