
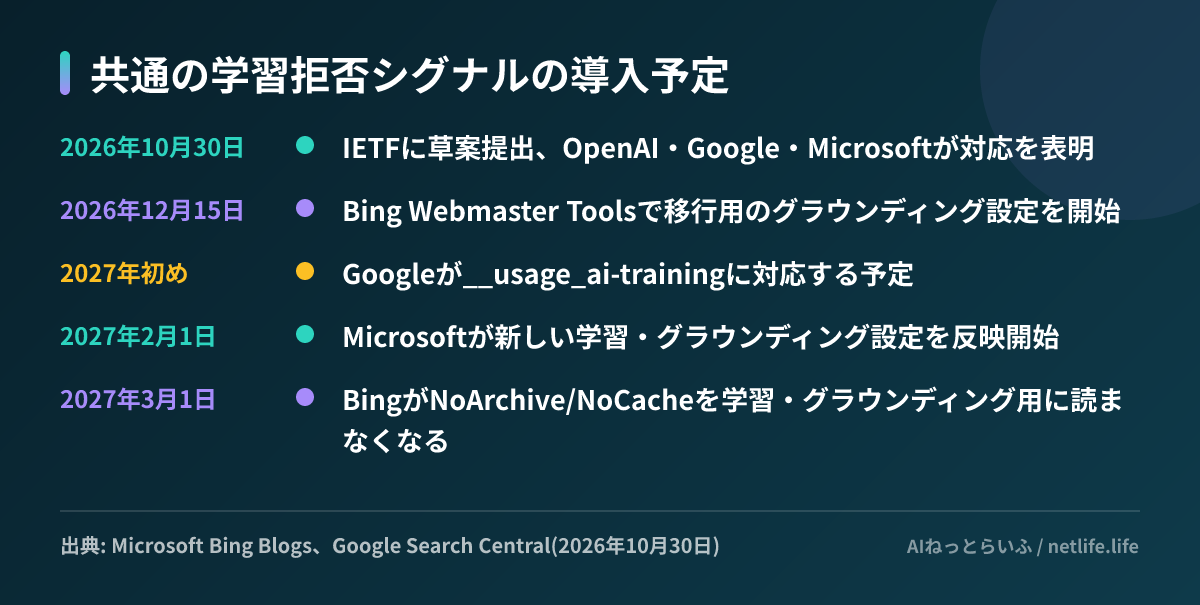
OpenAI、Google、Microsoftは2026年10月30日(米国時間)、Webサイトの運営者がrobots.txtに共通の目印「__usage_ai-training」を書くだけで、参加する各社に「このサイトの内容をAIの学習に使わないでほしい」と伝えられる仕組みに対応すると、それぞれ発表しました。これまではGPTBot、Google-Extended、ClaudeBotなど会社ごとの名前を並べる必要がありましたが、1つの書き方で済むようになります。検索結果への掲載には影響しない設計で、Googleは2027年初め、Microsoftは2027年2月1日から反映するとしています。自社サイトやメディアを運営していて、AI学習への提供方針を決めたい人に関係するニュースです。
何が決まったのか
土台になっているのは、IETF(インターネット技術の標準化団体)に10月30日付で提出されたインターネットドラフト「Machine-Readable Training Preference Signal」です。著者はAnthropicのKevin Kelley氏で、AI利用の意思表示を扱うIETFのAIPREFワーキンググループの用語定義に沿っています。ただし現時点では個人提出の草案で、IETFが正式に承認した標準ではありません。
書き方は、robots.txtの User-Agent 行に、実在のクローラー名の代わりに用途を表す名前を置くものです。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
この例は「サイト全体をAI学習に使わないでほしい。ただし /press-kit/ 以下は使ってよい」という意味になります。草案は「新しい命令名も新しい文法も導入しない」としており、既存のrobots.txtの書式のまま使えるのが特徴です。
各社の発表内容は次のとおりです。
- Google: Search Centralブログで共通の学習制御に対応する計画を発表しました。クローラーの説明文書には「2027年初めに対応する予定」と明記されています。既存のGoogle-Extendedは引き続き使え、Google検索の掲載や順位には影響しないと説明しています
- OpenAI: 公式ニュースで、共通のrobots.txtの目印を尊重すると表明しました。今回確認できた範囲では、具体的な開始日は示されていません
- Microsoft: Bingのブログで、2027年2月1日からクロールに合わせて新しい設定を反映すると発表しました。Bingの検索結果への掲載資格は変わりません
なぜ共通の目印が必要だったのか
生成AIの学習用クローラーは会社ごとに名前が違い、しかも同じ会社でも「学習用」「検索用」「ユーザーの依頼で取りに来るもの」が分かれています。たとえばOpenAIはGPTBot(学習)とOAI-SearchBot(ChatGPTの検索)を、AnthropicはClaudeBot(学習)とClaude-SearchBot(検索)を分けています。運営者は新しい会社やクローラーが現れるたびにrobots.txtを書き足す必要があり、うっかり検索用まで止めてAI検索からの流入を失う、といった事故も起こりがちでした。
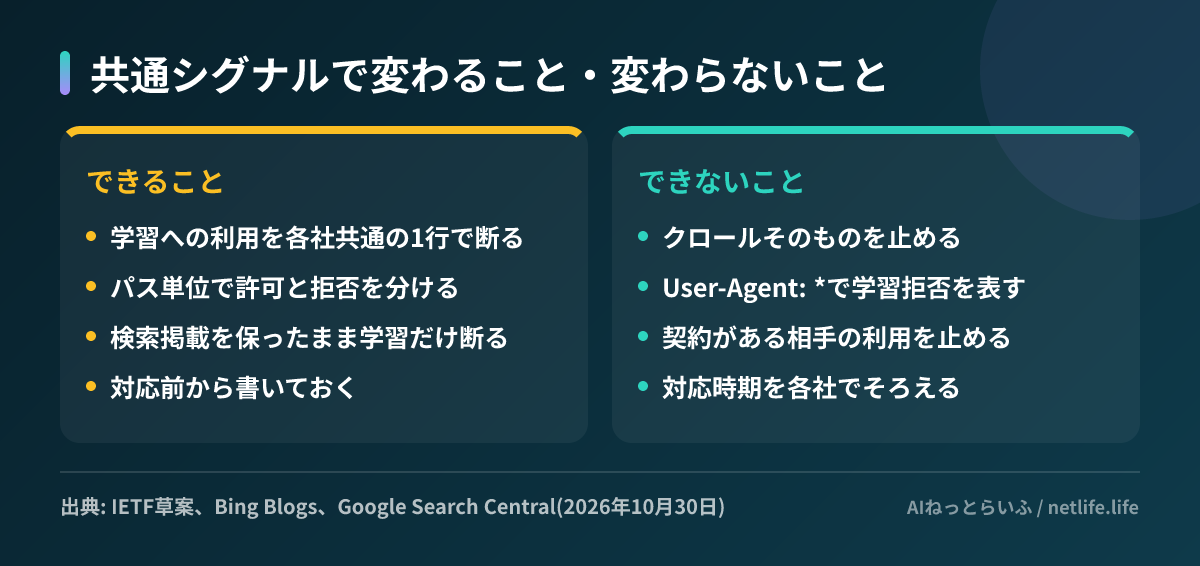
共通の目印は「どのクローラーか」ではなく「何に使うか」で意思を示すため、この問題をまとめて解消しようとするものです。草案は、この目印が「クロールの可否を指示するものではない」と明記しています。取得そのものを止めたい場合は、従来どおりクローラー名ごとに Disallow を書く必要があります。
押さえておきたい細かいルール
実装時に誤解しやすい点がいくつかあります。
- User-Agent: * のグループは、この目印に当てはまらないと草案は定めています。全クローラー向けに Disallow を書いていても、学習拒否の意思表示にはなりません
- 目印を書いていない場合は「意思が示されていない」扱いです。拒否したことにはなりません
- 個別の契約がある場合は、契約が優先され得ると草案は書いています
MicrosoftはさらにAIの「グラウンディング」(回答を作るときに参照情報としてWebの内容を使うこと)も分けて扱います。ページ単位で <meta name="Bingbot" content="ai-grounding:disallow"> などを書く方式で、許可・Microsoftの自社サービスだけに限定(DisallowExtended)・拒否の3段階を選べます。サイト全体をrobots.txtで指定する方法はグラウンディングには用意されていません。また、2023年から使われてきたNoArchive/NoCacheは、2027年3月1日以降、学習やグラウンディングの意思表示としては読まれなくなります。
日本の読者にとっての影響
日本では著作権法30条の4により、AIの学習目的の利用が比較的広く認められています。そのため、robots.txtでの意思表示が法的にどこまで効くかは別の論点で、今回の仕組みはあくまで各社が自主的に尊重する技術的な取り決めです。とはいえ、文化庁が2024年にまとめた「AIと著作権に関する考え方について」でもrobots.txtなどの技術的な措置が論点として扱われており、意思表示を残しておくことの意味は小さくないと考えられます。
実務上の変化は、記事メディアやECサイト、企業サイトの担当者が「AI検索には載りたいが、学習には使われたくない」といった方針を、少ない記述で表せるようになる点です。一方で各社の対応時期はそろっておらず、Googleは2027年初め、OpenAIは時期未定です。当面は共通の目印だけに頼らず、既存のクローラー名ごとの指定も残しておくのが安全です。
なお、草案の著者はAnthropic所属ですが、AnthropicのClaudeBotが共通の目印をいつから尊重するかは、同社の公式ヘルプでは今のところ案内されていません。
次にやること
- 自社サイトのAI学習への提供方針(全体拒否、一部だけ許可、許可)を決め、決まったらrobots.txtに User-Agent: __usage_ai-training のグループを追記する。各社の対応前に書いても害はありません
- 既存のGPTBot、Google-Extended、ClaudeBotなどの指定は消さずに残し、検索用クローラー(OAI-SearchBot、Claude-SearchBotなど)まで止めていないか見直す
- BingでNoArchive/NoCacheを学習対策として使っている場合は、2027年3月1日までに新しいmetaタグ(ai-training:disallow など)へ切り替える


