
Cloudflareは2026年10月26日(米国時間)、AI推論サービス「Workers AI」で提供している中国Z.aiのモデルGLM-5.3で、ある利用者への応答に別の利用者のリクエスト内容が混ざる事故があったと公表しました。期間は8月27日から9月9日、該当は155件の応答です。原因はサーバーの設定ミスと、広く使われている推論エンジンSGLangの不具合が重なったことでした。Workers AIの利用者だけでなく、SGLangで自社のLLMを運用している企業にも関係する話です。
何が起きたのか
影響を受けたのはGLM-5.3(@cf/zai-org/glm-5.3)だけで、他のWorkers AIのモデルは対象外とされています。混入が起きたのは、68万1,280トークンを超える非常に長いプロンプトを送ったときに限られ、返ってきたのは同じモデルに直前に送られた他の利用者のリクエストの内容でした。Cloudflareは、意図的に悪用された形跡はなく、該当リクエストは通常の長文利用と見られるとしています。
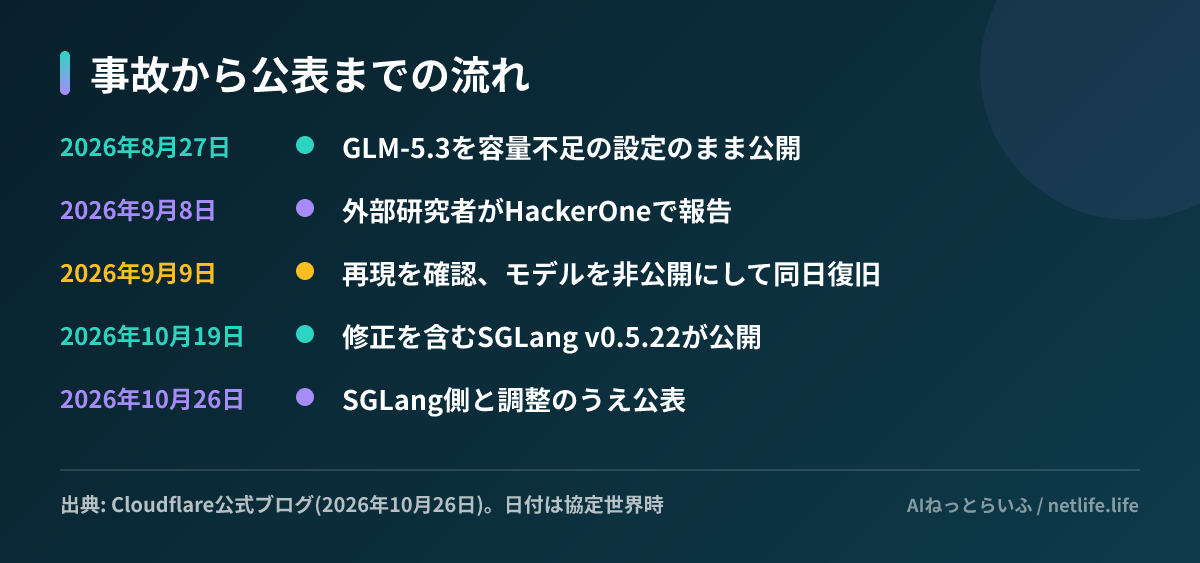
発見のきっかけは外部の研究者です。セキュリティ企業KnosticのGadi Evron氏が9月8日にHackerOne(脆弱性報告の窓口サービス)経由で報告し、Cloudflareは翌9日に再現を確認してモデルを非公開にし、同日中に修正版を戻しました。
なぜ他人のデータが返ったのか
LLMの推論では、読み込んだプロンプトの計算結果を「KVキャッシュ」というメモリ領域に保存し、続きの文章を生成するときに参照します。Cloudflareは、プロンプトを読み込む処理(prefill)と文章を生成する処理(decode)を別々のサーバーに分ける「分離構成」でSGLangを動かしていました。大規模サービスで効率を上げるためによく使われる構成です。
一つ目の問題は設定です。GLM-5.3は104万8,576トークンの文脈長で公開されましたが、prefill側のKVキャッシュは68万1,280トークン分しかありませんでした。Cloudflareは公開前にこの食い違いに気づいていたものの、長文テストが正常な応答(HTTP 200)を返していたため、問題ないと判断していたといいます。
二つ目はSGLangの不具合です。容量を超えたリクエストは「拒否」の印を付けられ、1トークンだけの仮の中身に差し替えられます。ところが分離構成の受け付け処理は「終わったかどうか」だけを見て「拒否されたかどうか」を見ていなかったため、処理がそのまま進みました。その結果、decode側は他の利用者のデータが残ったままの古いKVキャッシュを参照して文章を作り、エラーではなく正常な応答として返してしまいました。
教訓として大きいのは、テストが「成功」していたことです。エラーが出ない限り異常に気づけない作りでは、今回のように中身が別人のものでも見逃されます。同じ不具合に関連する報告は7月6日にSGLangのissueとして出ていたとされ、既知の兆候を拾えなかった点も示唆的です。
修正内容と運用者への推奨
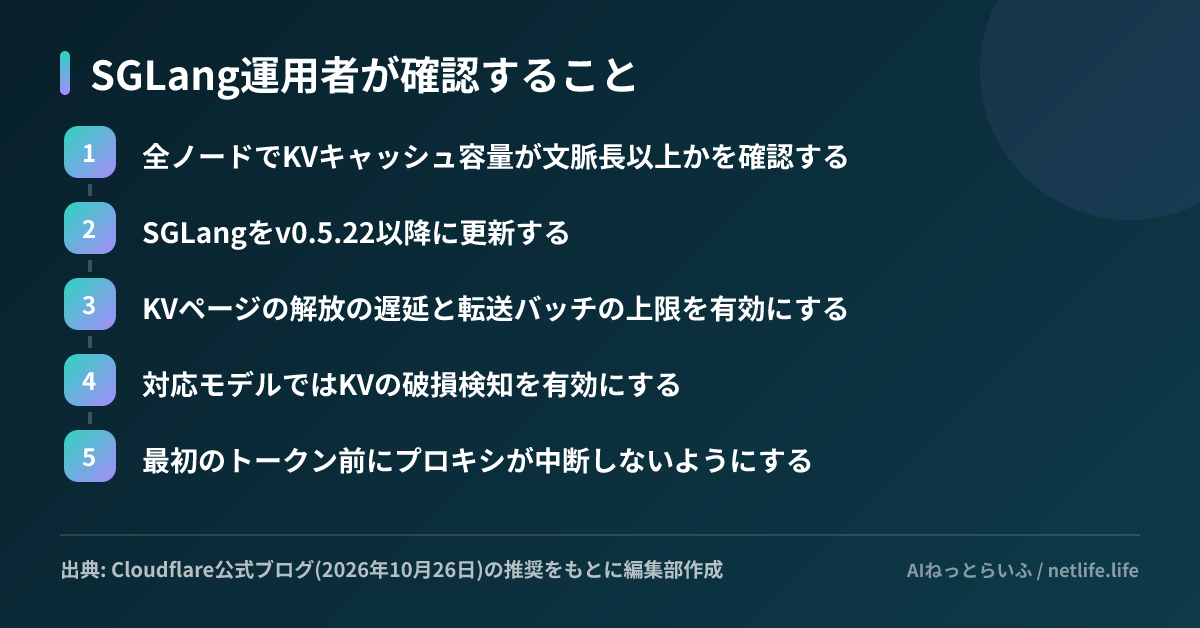
Cloudflareは、KVキャッシュを文脈長の約2倍にあたる約204万トークンに拡張し、拒否されたリクエストを受け付けの段階で元のエラーのまま終わらせる修正をSGLang本体に取り込みました。さらに、転送したKVキャッシュの整合性を確かめるチェックサムのオプション(--disaggregation-enable-kv-checksum)などを追加しています。
一方で、Workers AIの利用者がすべきことは記事に書かれていません。影響を受けた利用者に個別に連絡したかどうかも明記されていないため、該当期間に長文でGLM-5.3を使っていた場合は、Cloudflareに直接問い合わせるのが確実です。
日本の読者にとって
社内の機密を外に出さないために、オープンウェイト(重みが公開された)モデルをSGLangやvLLMで自社運用する日本企業は増えています。今回の事故は、自前で動かしても推論エンジンの設定次第で利用者間のデータが混ざり得ることを示しました。社内向けでも、部署や顧客ごとにデータを分けている環境なら同じ問題になります。先日紹介したCohereによるモデルの不審な外部送信の報告と合わせると、モデルそのものと推論基盤の両方を疑う運用が必要になっていると考えられます。
読者が次にやることは3つです。
- SGLangを使っているなら、バージョンと分離構成の有無、KVキャッシュ容量と文脈長の関係を今週中に確認する
- 推論APIの事業者を選ぶときは、利用者間の分離とインシデント時の通知方針を質問項目に加える
- 長文テストでは「エラーが出ないこと」だけでなく、応答の中身に目印の文字列を入れて取り違えがないかを確かめる


