
米Reflection AIは、10月5日に発表した大規模言語モデル「Beam」の重みを、Apache 2.0ライセンスでHugging Faceに公開しました。総パラメーター5,010億(501B)・1トークンあたりの活性パラメーター230億(23B)のMoE(専門家混合)モデルで、BF16・FP8・NVFP4の3形式がそろっています。4ビット形式のNVFP4版は約280GBで、NVIDIA B200を2枚つなげば重みが収まる大きさです。商用利用や追加学習に条件のない大型モデルを自社環境で動かしたいチームにとって、検証を始められる段階に入りました。
予告どおり月内に公開、米国勢の「持てる大型モデル」が続く
Beamは発表時の記事で紹介したとおり、コーディングとエージェント用途に絞ったモデルです。Reflection AIは「重みは10月中に公開する」と予告しており、今回のHugging Faceブログ(10月16日付)でそれが実現しました。
前日には、Metaも816BのMuse Spark Openの重みを公開しています。Muse Spark OpenはNVFP4版でも700GB以上のメモリが必要で、ライセンスには表示義務や大規模事業者向けの別契約といった条件が付きます。Beamは文字入力・文字出力だけのモデルですが、そのぶん小さく、ライセンスも標準的なApache 2.0です。中国製モデルの採用を避けたい企業が、米国発のモデルを実際に動かして比べられる状況になりました。
3つの形式と、動かすのに必要なGPU
公開されたリポジトリは、reflection/Beam-1.0-501B-A23B(BF16)、-FP8、-NVFP4 の3つです。NVFP4はNVIDIAの4ビット浮動小数点形式で、ブログは「BF16で1TBある重みを約280GBに縮める」と説明しています。
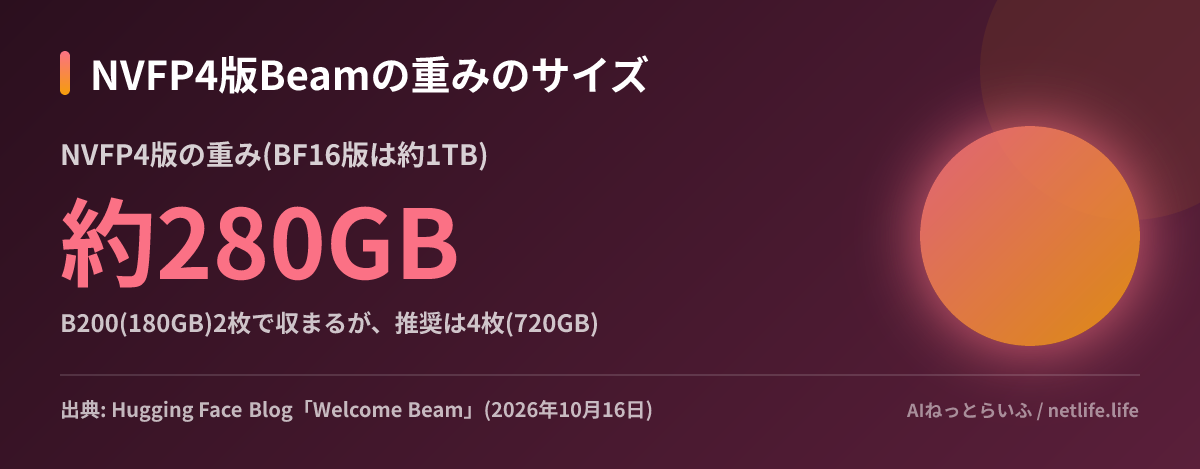
ブログが示す構成は次のとおりです。B200は1枚180GBなので2枚(360GB)で重みは載りますが、長い文脈や同時リクエストの余裕を考えて「B200を4枚(720GB)用意する」ことを勧めています。ほかにB200 8枚の1ノード、B300(288GB)2枚、RTX Pro 6000 8枚でも動かせるとしています。
注意したいのは、NVFP4を直接扱えるのはBlackwell世代のGPUだけという点です。H200などそれ以前のGPUではFP8版を使います。SGLangの例では、NVFP4はB300 4枚、FP8はH200 8枚の構成です。Transformers、vLLM、SGLangは公開初日から対応しています。
推論の深さは low・medium(既定)・high・xhigh・max の5段階で指定できます。小さな下書きモデルが最大15トークン先まで候補を出し、Beamが1回の計算でまとめて確かめる投機的デコーディング「DFlash2」も用意されています。ただし、どれだけ速くなるかの数値は示されていません。
自前のGPUがない場合は、Hugging FaceのInference Providers経由でBaseten、Fireworks、Togetherから使えます。料金はブログには載っていません。
4ビットにしても性能はほぼ保たれる
実務で気になるのは、NVFP4にしたときの性能低下です。ブログには3形式の比較表があり、Reflection AIによる数値では、多くの評価で差は2ポイント以内でした。
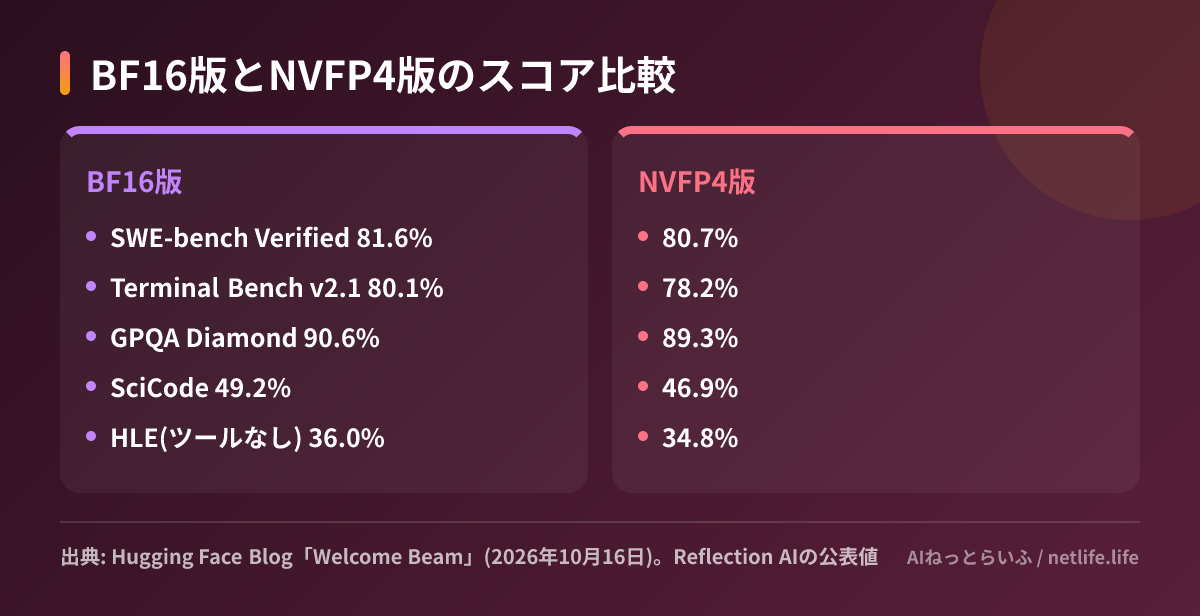
一方、SciCodeのように2ポイント以上下がる項目もあります。また、SWE-bench VerifiedのBF16版の値(81.6%)は、10月5日の発表記事の値(80.9%)と一致しません。測定条件の違いによるものと考えられますが、説明はありません。いずれも第三者の検証を経ていない数値です。
追加学習の手順も公開されました。TRLでLoRAによる追加学習を行う例では、B300 8枚の1ノードで毎秒約1万9,000トークンを処理できます。この例は「ユーザーが指定した言語で推論過程を書かせる」ためのもので、指定言語で推論できたのは元のモデルが16問中3問、学習後は16問中16問でした。強化学習(GRPO)のレシピもRadixArkのMilesで提供されています。
日本の利用者にとっての意味
日本語の性能について、公開された資料は何も触れていません。前述の追加学習の例では、元のモデルが指定された言語で推論できたのは16問中3問だけでした。日本語の指示でも推論過程は別の言語になる可能性があります。日本語で使うなら、社内の文書やタスクで回答の質を自分で確かめる必要があります。推論過程を日本語にしたい場合は、同じ手順で追加学習するのが現実的な選択肢になりそうです。
Inference Providersの3社はいずれも米国の企業です。データを国内から出せない業務では自前で動かすことになり、B200やB300級のGPUを最低2〜4枚確保できるかが分かれ目になります。国内のGPUクラウドでBlackwell世代をどれだけ借りられるかも、あわせて確認が必要です。
もう1点、細かいですがハマりやすい箇所があります。ブログのTransformersのコード例ではリポジトリ名が reflectionai/ になっていますが、ほかの例は reflection/ です。DFlash2の下書きモデルの名前も、vLLMとSGLangの例で異なります。コピーして動かないときは、まずリポジトリ名を疑ってください。
次にやること
- まずInference Providers経由で、自社のコーディングやエージェントのタスクを日本語の指示で試し、品質を確かめる
- 自前で動かすなら、Blackwell世代はNVFP4版、Hopper世代はFP8版を選び、B200 4枚相当のメモリを見積もる
- Muse Spark Openなど他のオープンモデルと、ライセンス条件と必要メモリを並べて比較する


