
東京のAI企業Sakana AIの研究チームが、LLM(大規模言語モデル)に論文の査読を手伝わせるときの評価方法と、そのための査読システムを論文として公開しました。人間の査読文に「似ているか」ではなく、論文に紛れ込ませた矛盾を「見つけられるか」で採点するのが特徴です。論文の中心となる主張に仕込んだ矛盾は、4回分の査読を合わせると7割超を検出しました。査読の負担に悩む研究者や、社内の技術文書レビューにAIを使いたい人に関係する結果です。
論文は機械学習の査読付き論文誌TMLR(Transactions on Machine Learning Research)に2026年7月に採録され、arXivには10月8日に投稿されました。
なぜ「似ているか」では足りないのか
機械学習分野では投稿数の急増で査読者が足りず、1人あたりの負担が増えて質が下がっていると指摘されてきました。arXiv自身も、AI生成の低品質な論文で審査が逼迫しているとして投稿数を1人月2本に制限したばかりです。
そこでLLMを査読の補助に使う研究が増えていますが、これまでの評価は主に「AIの査読文が人間の査読文とどれだけ似ているか」を測るものでした。著者らはこれを「模倣」の評価だとし、査読でいちばん手間がかかり価値もあるのは誤りの発見だと主張しています。人間の査読文に似ていても、論文の致命的な矛盾を見落としていては役に立たない、という問題意識です。
矛盾を埋め込んだベンチマークの作り方
研究チームはACL 2025、AISTATS 2025、CVPR 2025、ICML 2025、NeurIPS 2024の採択論文から、CCライセンスの257本を選びました。まずGemini 2.5 Proで論文ごとに「主張・根拠・手法」の関係を知識グラフにし、GPT-4.1でその一部と食い違う記述を書き加えて、計1,164個の矛盾を埋め込んだ版を作っています。
矛盾には、論文の中心的な主張からの「距離」が付いています。距離0は主張そのもの、数字が大きいほど細部です。査読システムの出力に矛盾の指摘が含まれているかはo3が10回判定して平均します。改変していない論文26本での判定精度は99.9%でした。
この方式なら正解がはっきりしているので、査読システム同士を数字で比べられます。一方で著者ら自身、50件を点検したところ34%は前後の文とのつながりが不自然で、8%は明らかにAIが書いた文に見えたと認めています。現実の誤りより見つけやすい可能性がある、ということです。
3段構えで読む査読システムMLR
あわせて提案されたのが、MLR(Multi-Layered Review)という査読システムです。人間の査読者がいきなり講評を書かず、まず全体を把握してから細部を読むのと同じ順序をとります。
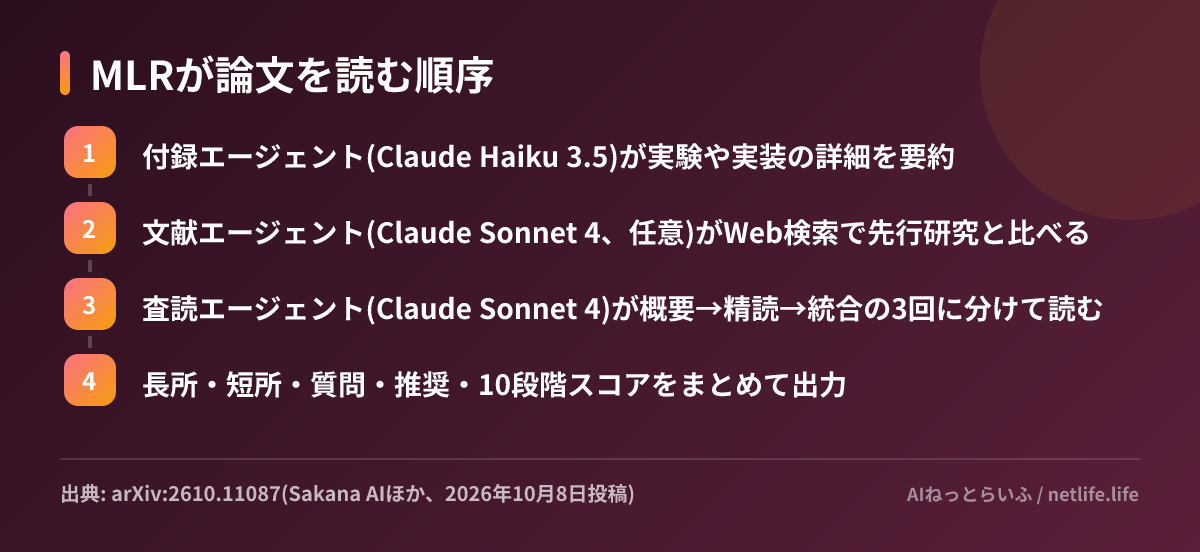
本文は10ページまでで、PDFを画像とテキストの両方で渡します。既製のAPIモデルだけを組み合わせており、GPUや追加学習は不要です。
結果: 核心部分の矛盾は7割超、実在の撤回論文では2割台
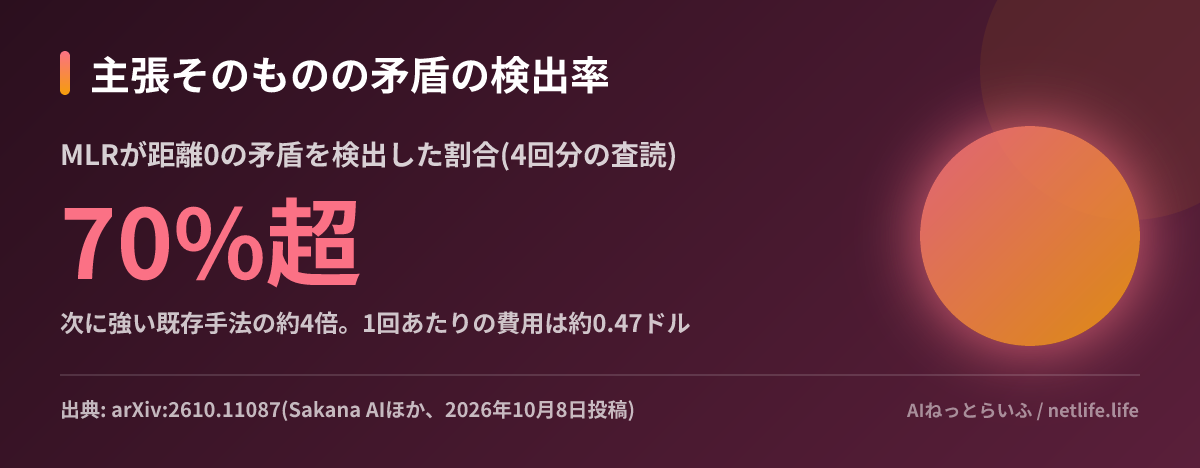
距離0、つまり主張そのものに仕込んだ矛盾について、MLRは4回分の査読を合わせると70%超を検出しました。論文は、次に強い既存手法(AgentReviewなど3種)の4倍の水準としています。使うモデルをClaude Sonnet 4に替えるだけでも既存手法の成績は上がりましたが、MLRの設計でさらに大きく伸びたとされ、モデル選びと仕組みの両方が効いているという結論です。
より現実に近い試験として、実際に撤回されたarXiv論文211本で撤回理由を指摘できるかも調べています。理由と似た指摘ができた割合は26.07%、ほぼ一致した割合は16.11%で、既存手法の最高値(18.48%、9.00%)を上回りましたが、絶対値としてはまだ低い水準です。
人間の査読スコアとの相関(ピアソン相関係数)は、ICLR 2025で0.586でした(人間同士は0.742)。ICML 2025では別の既存手法をわずかに下回っています。費用は文献エージェントを除いて1回約0.47ドル、入力は約19万トークンで、比較したAI Reviewerの約半分のトークン量です。1ドル150円で換算すると1回70円ほどになります。
弱点: 隠し指示と、人間とのズレ
不採択だった論文50本の末尾に評価を上げさせる文を埋め込んだ実験では、調べたすべてのシステムでスコアが上がりました。MLRの上昇幅は平均0.70点と小さめでしたが、埋め込みに気づいて指摘できたのは50本中8本だけです。著者らも、すべての査読システムが操作に弱いと結論づけています。
また、研究者による38回のレビューセッションでは、MLRのコメント378件のうち81%に同意が得られた一方、短所の指摘への同意は68%にとどまりました。MLRは実験の妥当性を重く見る傾向が強く、新規性や読みやすさを重視する人間とは注目点がずれています。著者らはこれを補完的な視点として位置づけています。
なお、実験に使われたのはClaude Sonnet 4やHaiku 3.5など1世代以上前のモデルです。現行モデルなら数字は変わる可能性があります。コードとデータは公開リポジトリではなく、問い合わせに応じて提供するとしています。
日本の読者にとっての意味
Sakana AIは2025年、AIが書いた論文がICLRのワークショップの査読を通過したと発表して話題になりました。今回は逆に、AIが論文を「審査する側」に回るときの物差しを示した形です。
国内でも学会の査読負担は課題ですが、多くの国際会議は機密保持の観点から、査読者が未公開の投稿論文を外部のLLMに入力することを制限しています。すぐに正式な査読をAIが担うというより、投稿前のセルフチェックや共著者間の内部レビューで使うのが現実的な線だと考えられます。
すぐに試せることは次の3つです。
- 自分の論文や技術文書をAIにレビューさせるときは、「感想」ではなく「主張と実験結果の食い違いを探して」と誤りの発見に絞って頼む
- 1回で終わらせず、複数回レビューさせて指摘を突き合わせる(MLRも4回分を合わせて検出率を上げています)
- 社内でAIレビューを評価するなら、わざと誤りを仕込んだ文書を用意して検出できるかを測る


