Xiaomiが2026年9月22日、大規模言語モデル MiMo-V2.6 のProとFlashを、重み付きで公開しました。ライセンスはMIT。改変も商用利用も追加条件なしで認める、オープンウェイトの中でもっとも緩い部類のライセンスです。上位のProは総パラメータ1.02兆・推論時に動くのが420億という疎なMoE(Mixture of Experts、入力ごとに一部の専門家だけを動かす構成)で、文章・画像・動画・音声をそのまま受け取ります。自社でモデルを抱えたい企業にとって、選択肢の上限が一段上がった発表です。
公開されたもの
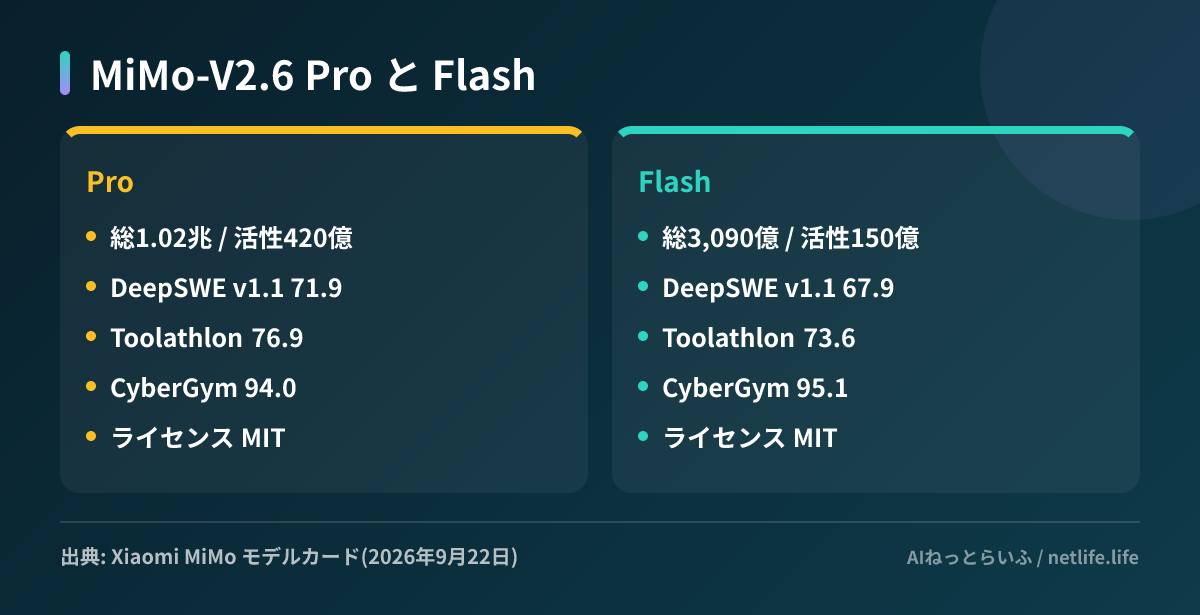
出たのは3つです。ProとFlash、それに小型のDistill-Qwen-9B。Proは総1.02兆・活性420億、Flashは総3,090億・活性150億で、どちらもコンテキストは100万トークンです。
Proの中身はモデルカードに細かく書かれています。言語側は70層で、スライディングウィンドウ注意と全体注意を混ぜた構成。ルーティングされる専門家は384個あり、1トークンあたり8個が動きます。画像は6.81億パラメータの独自ViT(Vision Transformer、画像を小片に分けて扱う視覚モデル)、音声は3.08億のAudioTokenizerと1.27億のパッチエンコーダが担当します。さらに5層のマルチトークン予測モジュールを投機的デコードに使い、生成を速くしています。
ベンチマークはモデルカードの値で、コードエージェント課題のDeepSWE v1.1がPro 71.9・Flash 67.9、ツール操作のToolathlon-VerifiedがPro 76.9・Flash 73.6、脆弱性探索のCyberGymがPro 94.0・Flash 95.1。CyberGymだけ小さいFlashが上回っているのが面白いところです。第三者指標では SiliconANGLEの報道 によると、Artificial Analysisの総合知能指数で46.32を記録し、オープンウェイトでは首位。ただし同指数の上位にいるクローズドモデルは53前後とされており、差は残っています。
学習費用まで公表した
今回いちばん珍しいのは、作るのにいくらかかったかを出したことです。 TechNodeの報道 によると、2モデルは強化学習(RL)を6日弱で30ステップ回し、使った軌跡は約75万件。開発費はProが262万ドル、Flashが85万ドルとされています。
手法面では、コーディング・汎用エージェント・視覚・セキュリティを分野ごとに別々に学習させるのではなく、1回の混合RLでまとめて回したとモデルカードに書かれています。分野をまたいで能力が移ることを狙った設計で、Flashのほうがセキュリティ課題で高い理由も、この混ぜ方と無関係ではないと考えられます。
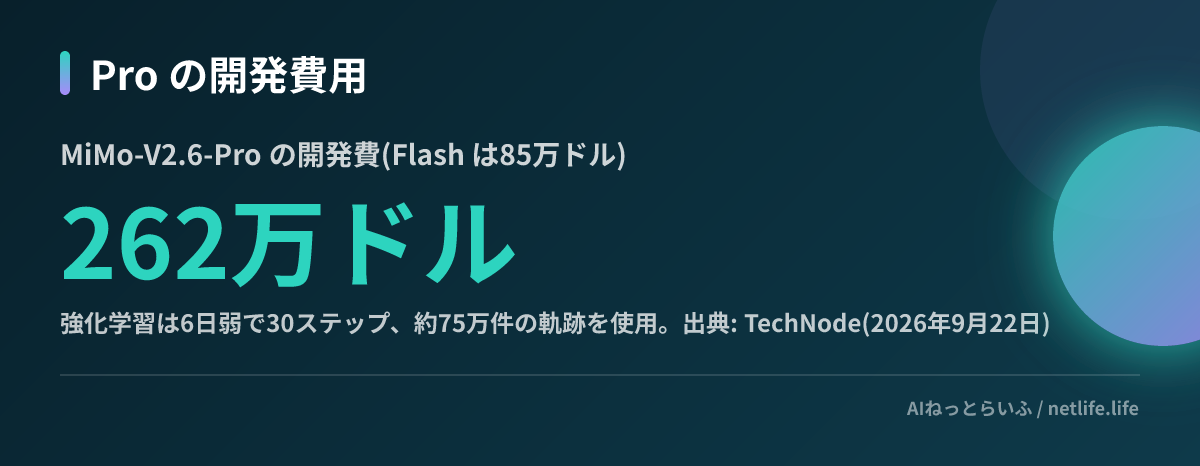
なお、この金額は事前学習を含む総額なのか強化学習の部分だけなのかが、報道からは読み取れません。額面をそのまま「1兆パラメータのモデルが3億円台で作れる」と受け取るのは早いです。
MITライセンスであることの意味
同じ週に、Alibabaが Qwen-Image-2.1のライセンスを研究用途限定に後退させた ばかりです。中国勢のオープンウェイト公開が一律に緩いわけではなく、むしろ商用条件を絞る動きも出ている中で、Xiaomiが最上位モデルをMITで出したのは対照的な判断と言えます。MITなら、社内システムへの組み込みも、ファインチューニングした派生モデルの配布も、原則として制限を気にせずに済みます。
ただし現実的な壁はサイズです。総1.02兆パラメータのProは、個人のPCどころか単一のGPUサーバーにも載りません。モデルカードはSGLangやvLLMでの複数ノード分散を前提にした設定例を載せています。Flashでも総3,090億なので、量子化しても相応の設備が要ります。「MITだから明日から自社で動かせる」という話ではありません。
日本の読者にとって
すぐ試すなら、Xiaomi公式の MiMoのAPI が100万トークンあたり入力0.435ドル・出力0.87ドル(キャッシュヒット時の入力は0.0036ドル)。同じ日に公開されたClaude Opus 5.5が入力4ドル・出力20ドルなので、出力側で20倍以上の差があります。レート上限は100 RPM・1,000万TPM、出力は最大12万8,000トークンです。
自社で重みを持てることの価値は、価格より置き場所にあります。データを国外のAPIに出せない案件で、性能が実用域のモデルを自前のクラウドに置ける選択肢が増えるからです。一方で、中国企業が公開したモデルを業務に入れる際は、調達ルールや情報セキュリティ規程で扱いが分かれます。ベンチマークもXiaomi自身の計測値が中心で、第三者の追試はこれからです。
次にやることを3つ。1つ目、まずMiMoのAPIで自社の代表的なタスクを10件ほど流し、Claude Opus 5.5やGPT系と同じ入力で出力を並べて品質差を測る。2つ目、自前ホスティングを検討するなら、Flash(総3,090億)を基準に必要なGPUメモリとノード数を見積もり、APIとの損益分岐点を出す。3つ目、社内の調達・セキュリティ規程で、公開重みのモデルを国内クラウドに置く場合の扱いが定義されているかを先に確認する。技術検証より、ここで止まるケースのほうが多いはずです。