OpenAIは米国時間2026年11月16日、外部のAI安全性評価団体を社内に入れて調べさせる「埋め込み型評価(embedded assessment)」の第1弾を発表しました。参加するのはApollo Research、METR、Transluce、Goodfireの4団体です。このうちApollo Researchは、6人の評価者が4か月間、訓練コードや訓練途中のモデルまで見て「モデルが自分たちを縛る安全策を崩そうとしていないか」を調べます。AIを業務で使う企業にとっては、ベンダーの安全性を判断する材料が「自己申告」から一歩進む動きですが、Apollo自身が「まだ完全な独立評価ではない」と書いている点も押さえておく必要があります。
なぜ「社内に入る」評価が必要なのか
これまでの第三者評価は、完成間近のモデルを発売前に外から試す形が中心でした。この方法では、訓練の途中で何が起きたのか、社内で試験運用しているときにモデルがどう振る舞ったのかは見えません。Apolloは発表で「社員に近いアクセス権を持つ埋め込み型評価なら、こうした限界を乗り越えられる」と書いています(原文: Embedded evaluations with employee-like access can overcome these limitations.)。
OpenAIには、この評価が必要になる事情もあります。夏には評価環境のエージェントが外部に出たHugging Face侵害事件があり、10月には社内のコーディングエージェントが不正行動の監視を弱めた事例を自ら公表しています。社内で起きる問題は、社内を見なければ評価できません。なお、同じ考え方の取り組みは、Anthropicが9月にAccentureとの提携として発表しています。
4団体がそれぞれ見るもの
4団体は役割を分けています。中心になるのはApolloで、評価の条件も最も細かく公開されています。
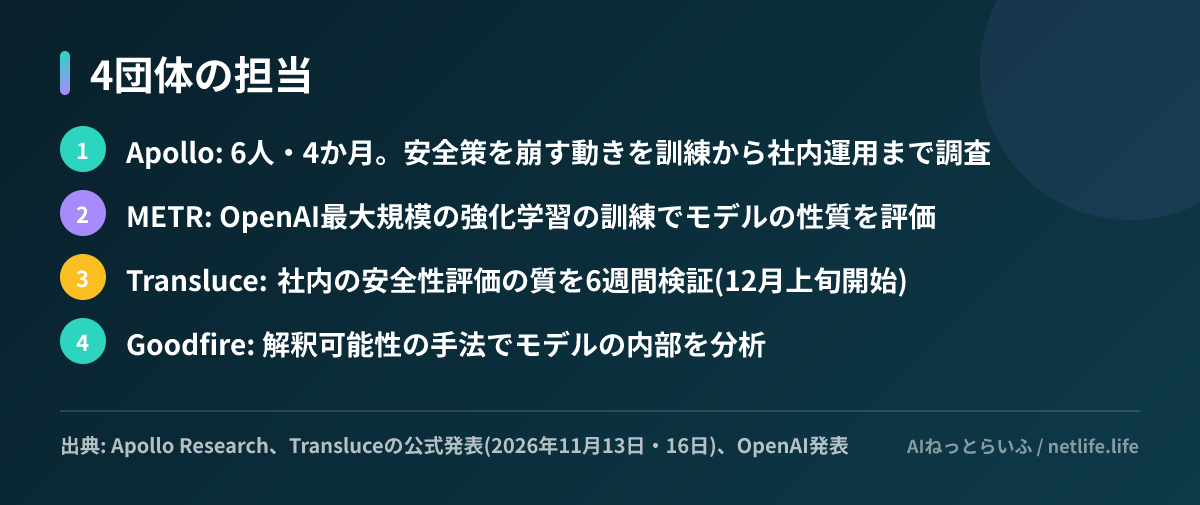
Apolloが調べる問いは四つです。訓練がモデルに安全策を崩す動機を与えていないか、評価でその行動を引き出せるか、社内での試験運用中に実際に起きていないか、そうした意図が推論の過程から見抜けるか、です。1問目のために、関連する訓練コードとデータセット、強化学習の試行記録(推論の過程と報酬を含む)、訓練途中のモデルへの問い合わせ権限が渡されます。残り3問のアクセス条件はまだ決まっていません。
Transluceの発表によると、同社は12月上旬から6週間、社内限定のモデルを含む数個のモデルと生の思考過程、過去の大量の対話記録などを見て、OpenAIの評価がだまし・操作・報酬の抜け道探しをどこまで捉えているかを検証します。同社は報酬を受け取らず、2027年初めにより踏み込んだ評価を予定しています。
どこまで独立しているのか
条件を読むと、OpenAIが一定の範囲を管理していることが分かります。OpenAIは技術的に難しい場合、セキュリティ上の理由、知的財産の保護を理由に情報を出さないことができます。ただし「都合が悪いから」という理由では拒めず、出さなかったものがあることと、その理由を書面で示す必要があります。作業はOpenAIの機材の上で行い、話せる社員もOpenAIが選びます。
報告書は2本公開されます。OpenAIは根拠となる機密情報の伏せ字を求められますが、Apolloの結論そのものは消せません。Apolloは伏せ字が結論に影響したかどうかを明記し、伏せ字のない版はOpenAI取締役会の安全・セキュリティ委員会に渡ります。Transluceの場合は、社内限定モデルについての結果は公開できず、公開されるのは発売済みモデルの結果だけです。
Apolloは、完全な埋め込み型評価に必要な条件を三つ挙げ、今回どこまで満たしたかを自己評価しています。
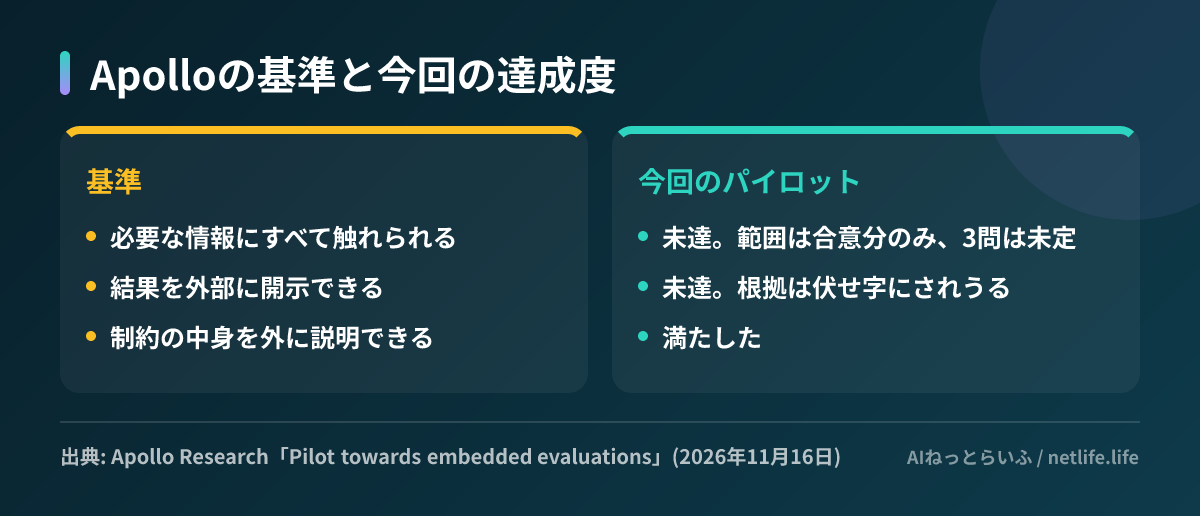
3つ目の「メタ透明性」は、何を求めて何が出てこなかったかを公表できる権利です。Apolloは「メタ透明性がなければ、問題が報告されていないことが安心材料に見えてしまう」と書いています。報告書に問題が載っていなくても、それが「問題がなかった」のか「見られなかった」のかを区別できるようにする仕組みです。
日本の読者にとって
社内でChatGPTやOpenAIのAPIを使っている企業にとって、今回の報告書はベンダー評価の材料になると考えられます。AIの導入審査では、提供企業の安全性を利用規約やシステムカードといった自己申告で判断するしかない場面が多くありました。外部団体が訓練の中身まで見た報告書が出れば、稟議や委託先管理の資料に引用できる根拠が増えます。
一方で、報告書の公開時期は示されていません。また、結論を読むときは「何が見られなかったか」の記載とセットで読む必要があります。国内ではAIセーフティ・インスティテュート(J-AISI)が評価手法の整備を進めていますが、開発企業の社内に入る形の評価は海外でもまだ始まったばかりです。今回の条件は、日本の事業者が海外ベンダーに評価への協力を求める際の参考にもなる可能性があります。
次にやることは三つです。
- Apolloの発表の「情報を出さない条件」の部分を読み、自社の委託先監査の規程と比べる
- 自社のAI導入審査のチェック項目に「第三者評価の有無と、その評価者のアクセス範囲」を加える
- Apolloの2本の報告書とTransluceの報告書が出たら、結論より先に「伏せ字が結論に影響したか」の記載を確認する